硬件成本直降30%:PD 分离场景下的 AI 推理网络拓扑优化方案详解
以无 Spine 双平面架构重构 KV Cache 传输路径,兼顾低时延、高吞吐与大规模集群扩展

当前大模型推理正从传统的“训练-推理复用集群”模式,向 Prefill-Decode(PD)分离的专用推理架构演进。架构变革对底层网络提出了全新且严苛的要求。
本文聚焦 AI 智算 AsterFabric Matrix 推理网络设计方案,该方案以星融元(Asterfusion) 数据中心 800G RoCE 交换机为硬件载体,从网络拓扑层面消除了 PD(Prefill-Decode) 分离场景下的结构性拥塞,面向非对称流量模型实现了更优的传输效率,同时在支持相同规模GPU集群的前提下,交换机数量减少33%,硬件成本降低约30%~40%。
PD 分离架构下的网络挑战
传统大模型算力集群普遍采用 Clos/Fat-Tree、ROFT 等对称拓扑,其设计初衷是服务训练场景下的 All-Reduce、All-to-All 等对称集合通信,当上述网络架构直接复用于 PD 分离推理时,则会暴露诸多问题。我们将从 PD 分离的原理与其流量模型出发,逐层拆解。
什么是 PD 分离?
在大模型推理中,PD 分离已成为提升系统效率的核心架构:
Prefill 阶段:负责接收用户输入的完整 Prompt,进行前向计算生成 KV Cache。该阶段计算密集,单次计算量大,但执行频率相对较低;
Decode 阶段:基于 Prefill 生成的 KV Cache,逐 Token 自回归生成输出。该阶段访存密集,计算量小但执行频率极高,对时延极度敏感。
PD 分离将两个阶段部署在独立的GPU实例池中,通过调度器将 Prefill 实例生成的 KV Cache 传输至指定的 Decode 实例,实现:
- 算力专业化:Prefill 池可配置高算力 GPU,Decode 池可配置高显存/高带宽 GPU;
- 弹性扩缩容:根据业务负载独立扩展 Prefill 或 Decode 实例数量,典型 P:D 配比为1:3;
- 批量优化:Prefill 阶段可充分利用大 Batch 提升计算效率,Decode 阶段通过连续批处理(Continuous Batching)降低空闲。
PD分离网络流量模型
| 特征维度 | 训练场景(All-Reduce) | PD分离推理场景(KV Cache传输) |
| 流量方向 | 对称、规律(环状/树状集合通信) | 高度非对称、方向随机(任意P节点→任意D节点) |
| 流量大小 | 相对固定(梯度/激活值大小可预测) | 动态变化(随上下文长度从数MB到数十GB不等) |
| 源目关系 | 同组内全互联,关系确定 | 源目关系不确定,取决于调度器分配 |
| 时延要求 | 同步等待,对平均时延敏感 | 对尾延迟(P99 TTFT)极度敏感 |
| 负载均衡 | 各节点负载相对均衡 | 网卡负载高度不均衡,易出现大象流集中 |
如上表所示,PD 分离解耦后的网络流量模型较传统架构发生根本性变化,与传统训练场景截然不同,可以总结为:“源-目的不对称、流量规模动态变化、流向几乎无规律”。
挑战1:哈希极化
传统 Clos/Fat-Tree 架构依赖 ECMP 逐流负载均衡,在 PD 分离场景下,当多个大流量的 KV Cache 传输(大象流)经过哈希计算后,极易被分配到同一条成员链路,导致该链路拥塞,而其他链路空闲。这种“总带宽充裕、局部严重拥塞”的哈希极化现象,是 PD 分离推理尾延迟飙升的首要元凶。
挑战2:结构性拥塞
通过 Rail 优化提升了训练场景下的 All-Reduce 效率,但其设计假设是流量对称且可预测。
在PD分离中,KV Cache 传输的“源-目关系”完全由调度器动态决定,Prefill 节点可能集中在少数 Leaf 交换机下,导致这些 Leaf 的上行链路被集中冲击,形成架构级热点。这种拥塞并非由瞬时流量突发引起,而是网络拓扑与 PD 分离流量模型不匹配导致的结构性拥塞。
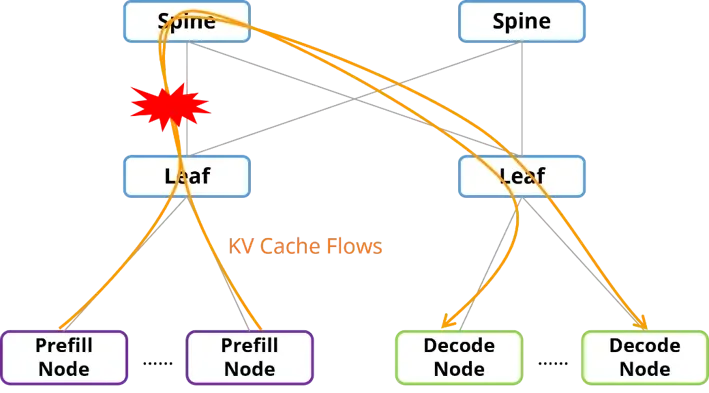
PD分离场景结构性拥塞
挑战3:多跳转发和 Spine 瓶颈
传统3层 Clos 架构中,跨 Leaf 的流量必须经过 Spine 层(从Leaf-A 到 Spine 再到 Leaf-B,共3跳)。在 PD 分离场景下,超过 90% 的 KV Cache 传输为跨 Leaf 流量,所有此类流量都需在 Spine 层汇聚。即使 Spine 层采用过度配置(Oversubscription),Spine 与 Leaf 层之间的链路仍会成为无法规避的瓶颈,且多跳转发进一步放大了传输时延。
AsterFabric Matrix 网络架构
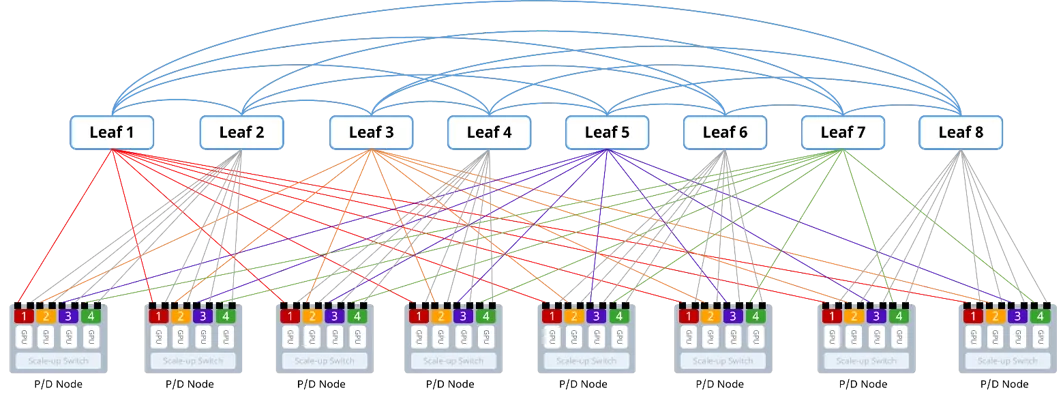
本方案提出的 AsterFabric Matrix 组网(以下简称 Matrix),是专为 PD 分离推理场景设计的网络架构,旨在从网络拓扑层面消除 PD 分离场景下的结构性拥塞,而非依赖上层调度或更复杂的传输层协议,其核心设计理念包括:
- 移除 Spine 层:彻底消除跨 Leaf 流量的汇聚瓶颈,将网络直径从3跳压缩至2跳;
- 完全二部图互联:Leaf 交换机分两组构成两个平面,平面 Leaf 之间 Full-Mesh 全互联,为 KV Cache 传输提供最短且确定的路径;
- 单轨+多轨混合接入:通过正交对偶分区,将结构化的 Prefill/Decode 节点块在底层链路中均匀散开,实现天然负载均衡;
- 确定性路由:每对 GPU 之间仅有一条最优路径,消除 ECMP 哈希冲突。
组网架构简析
Matrix 架构移除传统 Fat-Tree 架构的 Spine 交换层,将所有 Leaf 交换机均分为数量相等的两组:
- A平面(多轨平面,奇数组Leaf):编号为1, 3, 5, …
- B平面(单轨平面,偶数组Leaf):编号为2, 4, 6, …
两组交换机之间构建完全二部图全互联,任意一台 A 组交换机与所有 B 组交换机均有直连链路,平面内交换机互不连接。
每个 GPU 的双端口网卡分别接入两组交换机:
- 第一端口(多轨端口):按多轨规则接入A平面奇数 Leaf 交换机
- 第二端口(单轨端口):按单轨规则接入B平面偶数 Leaf 交换机
最小组网示例
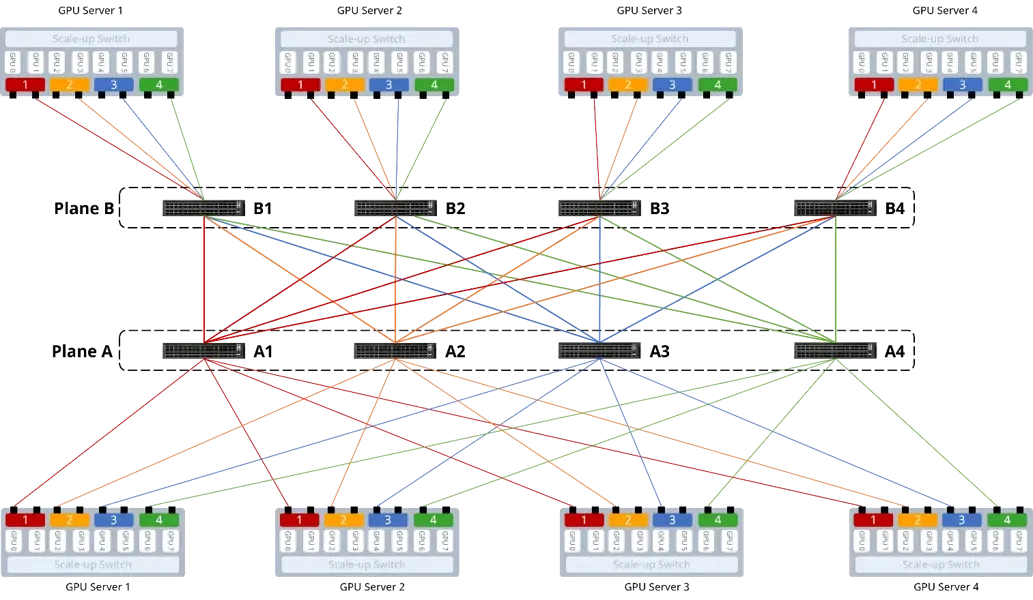
- 组网规模: 4 台 GPU 服务器 + 8 台 Leaf 交换机
- 接入效果: GPU Server 的多轨端口分别接入 A 平面 4 台 Leaf;Server 的单轨端口分别接入 B 平面的 4 台 Leaf;两组 Leaf 之间全互联。
在 Matrix 组网架构下,全网任意 GPU 间转发路径恒为两跳 :
GPU-A → 本组 Leaf → 对组 Leaf → GPU-B
对于 PD 分离场景,这意味着任意 Prefill 节点到任意 Decode 节点的 KV Cache 传输,均只需经过 2 台交换机,路径最短且唯一。
流量转发路径
同轨通信:Server 1 的 1 号 GPU 访问 Server2 的 1 号 GPU:
- ①
Server 1-1-A → Leaf A1 → Leaf B1 → Server 2-1-B两跳完成转发; - ②
Server 1-1-B → Leaf B1 → Leaf A1 → Server 2-1-A,两跳完成转发。
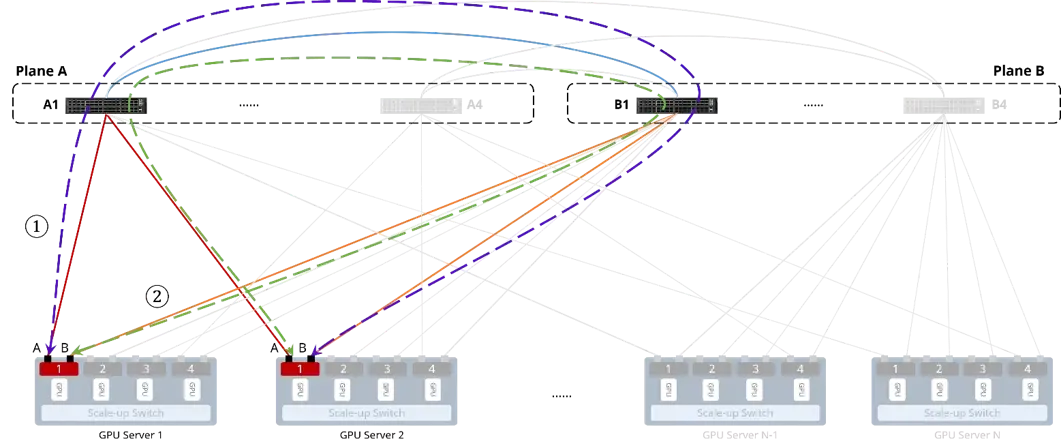
跨轨通信:Server 1 的 1 号 GPU 访问 Server2 的 4 号 GPU:
- ①
Server 1-1-A → Leaf A1 → Leaf B1 → Server 2-4-B,两跳完成转发; - ②
Server 1-1-B → Leaf B1 → Leaf A4 → Server 2-4-A,两跳完成转发。
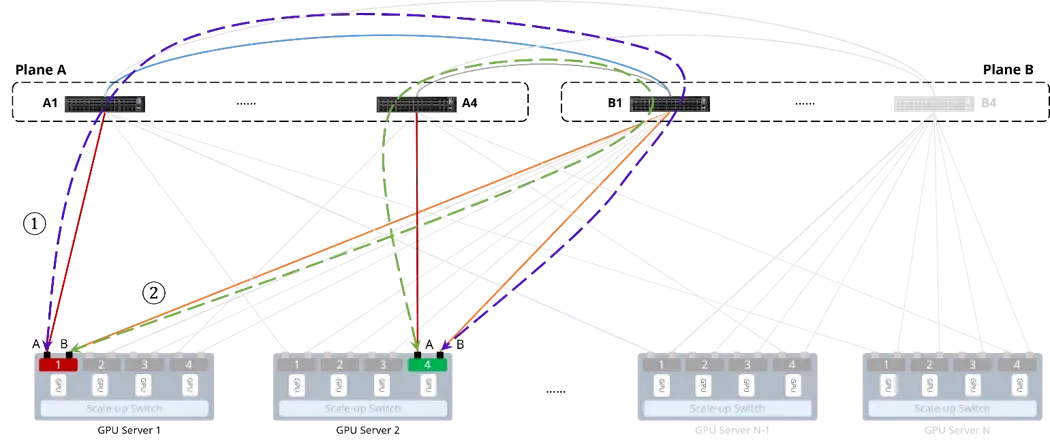
AsterFabric Matrix 关键技术
网卡双端口接入
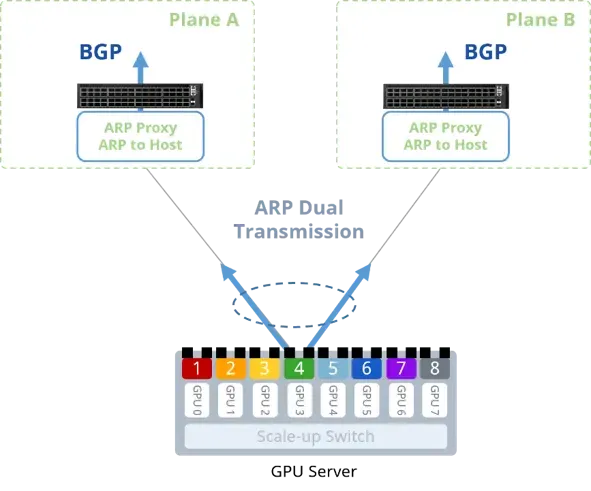
服务器的网卡采用 bond 模式双上行,分别连接到两个平面的 Leaf 交换机,为确保两台 Leaf 对服务器的 ARP 请求和 MAC 地址学习保持一致,需要启动以下机制:
- 网卡双发 ARP:服务器网卡需要具备向两个上行端口同时发送 ARP 请求的能力,这样两台 Leaf 交换机都能学习到服务器的 MAC 地址和 IP 地址;
- 交换机 ARP-to-Host 路由功能:Leaf 交换机开启 ARP-to-Host 路由功能,将学习到的 ARP 表项转换为 32 位的主机路由,并通过上行的 BGP 协议宣告给另一平面。
路由方案
为实现上述恒定两跳转发,要求严格过滤“一跳路由”(不允许通过本地路由转发流量)与“多跳路由”(避免平面A的流量经过平面B后再回到平面A):
- 同组 Leaf 配置相同 AS:通过 BGP AS 路径属性过滤大于两跳的路由,确保流量不会在同平面内转发或多次跨平面绕行;
- IPv6 Link-local 建立 Unnumbered BGP 邻居:A、B 平面间互联接口无需规划 IP 地址,利用 IPv6 link-local 地址自动建立 BGP 邻居,简化部署;
- 仅宣告 Host 路由:通过ARP-to-Host路由机制,每台 Leaf 仅宣告其直连 GPU 的主机路由,路由表精简,收敛迅速。
负载均衡
如上文提及,传统 ECMP 逐流负载均衡机制会带来哈希极化的问题,而 Matrix 的负载均衡能力来自优化后的拓扑设计:
- 完全二部图天然均匀分布:任意 A 平面 Leaf 与所有 B 平面 Leaf 全互联,流量在跨组链路中自然散开,无固有结构性热点链路;
- 单轨+多轨混合接入:多轨端口将相同槽位的 GPU 分散到不同 A 平面 Leaf,单轨端口将连续编号的 GPU 集中到 B 平面 Leaf。这种正交对偶分区确保无论流量是 Rail-aligned(训练模式)还是源目高度不均衡(PD分离模式),都能获得均匀的路径分布。
最大集群组网规模
服务器侧我们以 NVIDIA DGX H100 (每台搭载8个GPU)为例:
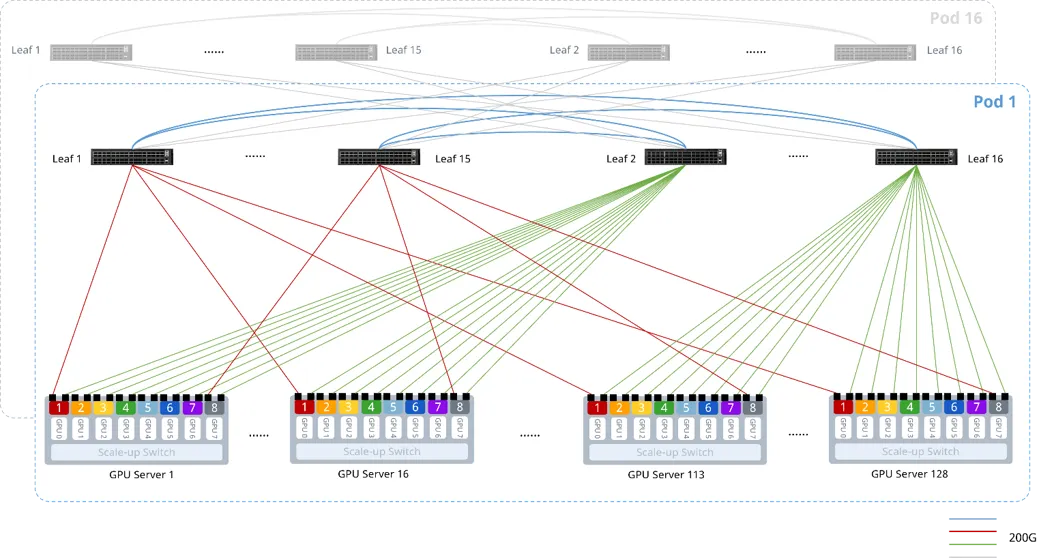
- 一个 Pod 需配置 16 个 Leaf 节点,对应两个平面各 8 个 Leaf。每个 Pod 可接入的服务器最大数量与 Leaf 节点的接口形态相关。
- 为保证1:1收敛比,Leaf 节点的一半接口用于连接 GPU 服务器,另一半接口用于连接另一平面的 Leaf 节点。
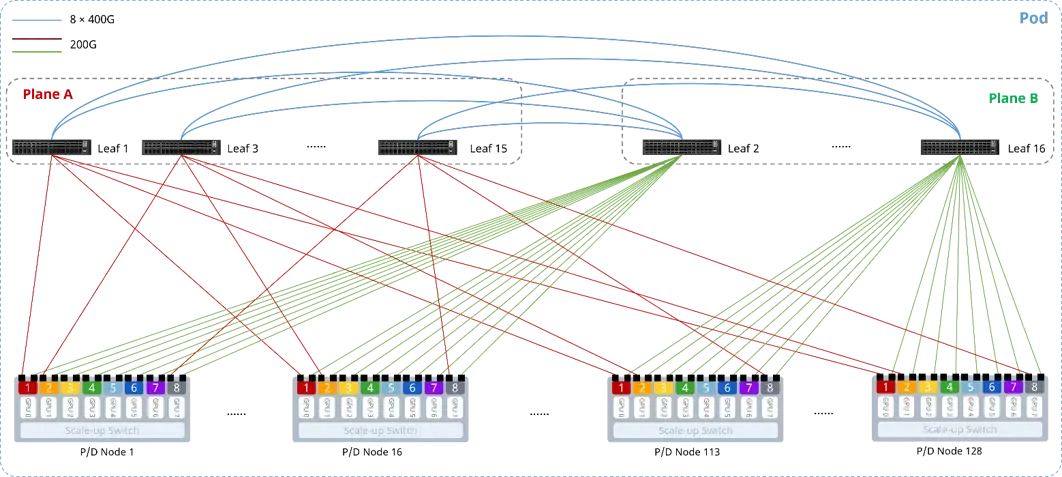
单Pod,1K GPU Matrix 组网
Matrix 组网移除了 Spine 层,Leaf 节点同时承担接入与互联角色,单 Pod 内全部节点同型号部署,运维备件型号单一。
Leaf 节点推荐采用星融元 CX864E-N RoCE 交换机设备,搭载星融元 AsterNOS, 单机提供 64 个 800GE 接口,通过接口拆分,可提供 128 个 200G 接口(连接 GPU Server)和 64 个 400G 接口(连接 Leaf 与 Leaf)。
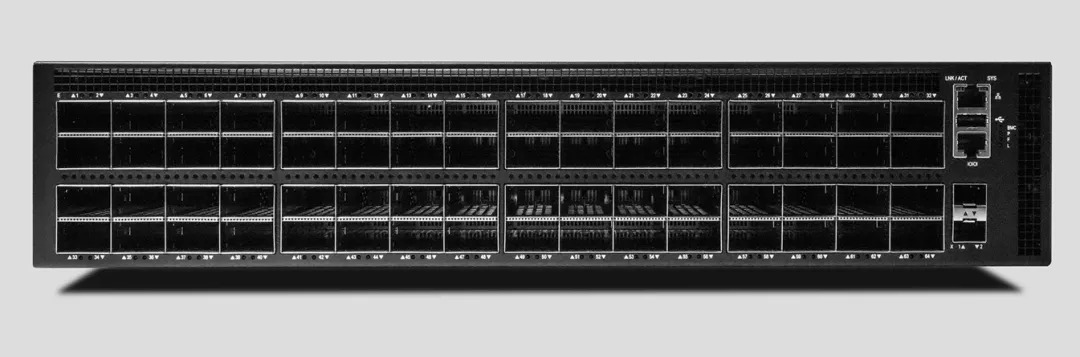
有关 CX864E-N 可参阅:51.2T 800G AI智算交换机拆机揭秘
综上:以星融元 CX864E-N 交换机、单 GPU 400Gbps 接入带宽(2 * 200Gbps),采用 Matrix 架构组网,集群单 Pod 可接入 128 台 GPU Server(1K GPU),最大可扩展 16 个 Pod,即最大集群规模为 16K GPU。
组网成本
以 8K GPU 集群规模为基准,对比星融元 AsterFabric ROFT、AsterFabric Dual-Mesh(轨道优化双平面网络)以及 AsterFabric Matrix 三种网络拓扑方案的硬件配置如下:
| 拓扑方案 | ROFT | Dual-Mesh | Matrix |
| 交换机 | 192台 | 192台 | 128台 |
| 800G模块 | 12288个 | 12288个 | 8192个 |
| 400G模块 | 8192个 | – | – |
| 线缆 | 12288条 | 12288条 | 10240条 |
根据上表可见,AsterFabric Matrix 组网在支持相同规模 GPU 集群的前提下,交换机数量减少33%,硬件成本降低约 30%~40%,同时专为 PD 分离的非对称流量模型提供了更优的传输效率。
更多开放网络技术分享和请持续关注星融元
星融元是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和SONiC软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。
产品型号: 星融元(Asterfusion)ET3600系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……
应用场景:企业路由器,路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18
产品型号: 星融元(Asterfusion)ET2500系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……
应用场景:路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18