吞吐提升21%,响应时延减半:PD分离推理场景的 AsterFabric Matrix 性能实测解析
从E2E转发、集合通信到模型推理,拆解星阵正交双平面架构的性能收益与适用场景

前言
本文主要介绍近期针对星融元 AsterFabric Matrix(星阵正交双平面)架构的测试,该测试意图验证该网络架构是否可提供与业界主流的 ROFT 网络相当的网络性能。
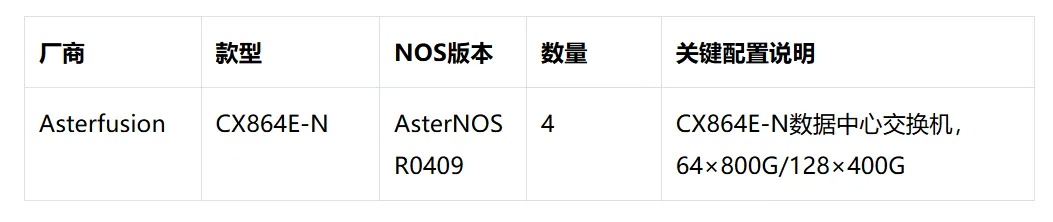
组网所用交换机为星融元数据技术有限公司的 800G RoCE 交换机(CX864E-N,64×800G/128×400G),搭载基于SONiC的AsterNOS网络操作系统;服务器侧为某国产GPU卡,单节点8卡,对应4个双口200G网卡(Broadcom PCIe以太网卡)。其余详细测试软硬件信息附于文末。
测试结论
AsterFabric ROFT 与 Matrix 两种组网架构在 E2E 转发及集合通信场景下均表现出良好的性能,接近参考基线。
在PD分离部署DeepSeek-V4-Flash模型的推理测试中,Matrix 架构展现出更高的总吞吐(提升21.7%)和更低的响应时延(首token时延降低50%,每输出token时延降低10%)。
测试拓扑
AsterFabric ROFT
AsterFabric 中的 ROFT 指的是 Rail-Optimized Fat-Tree,该架构通过将同轨的网卡接入到同一交换机提升了训练场景下的 All-Reduce 效率,只有涉及到跨Leaf通信时才会经由Spine层交换机完成转发。
在PD分离场景中,当多个大流量的KV Cache传输(大象流)经过哈希计算后,极易被分配到同一条成员链路,导致总带宽充裕,但局部严重拥塞。
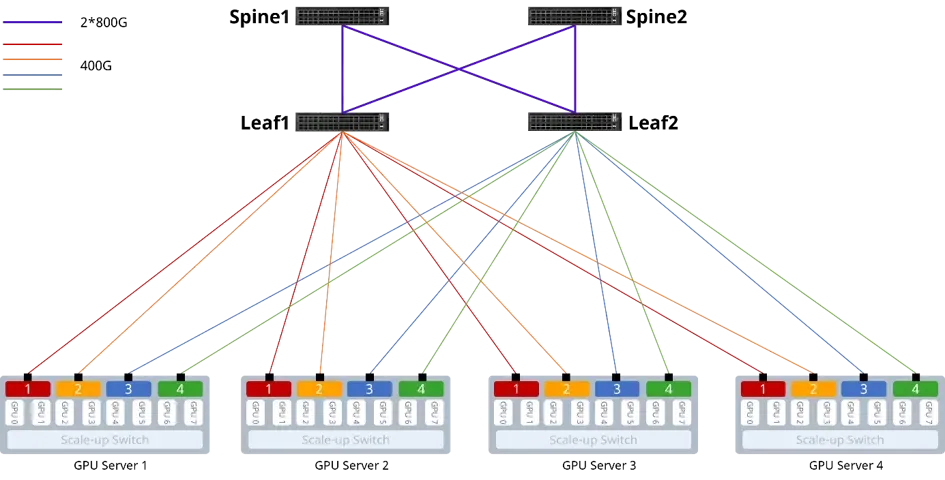
AsterFabric ROFT(轨道优化)测试拓扑
AsterFabric Matrix
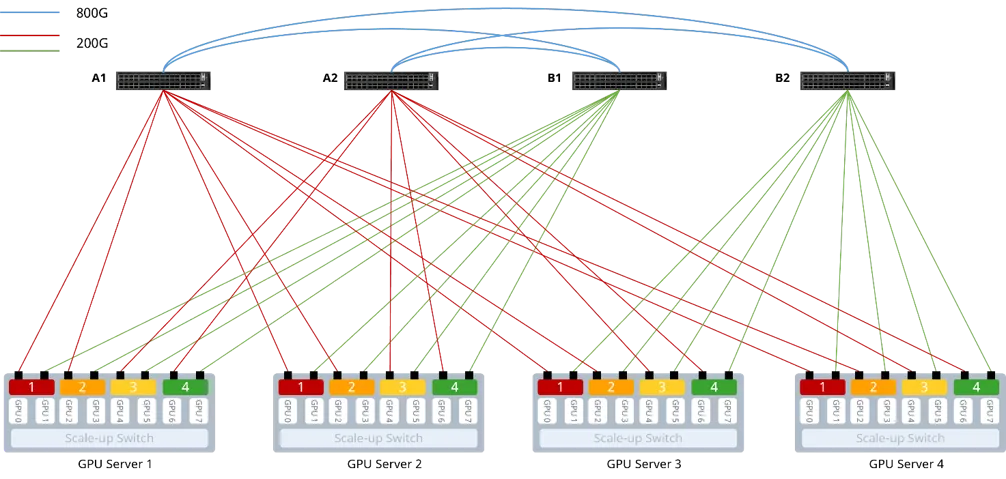
AsterFabric Matrix(星阵正交双平面)测试拓扑
Matrix 架构移除Spine层,将Leaf交换机分组全互联构成完全二部图,并采用单轨与多轨混合接入方式,配合确定性路由,实现全网恒定两跳转发,从拓扑优化层面消除 PD 分离场景下可避免的拥塞。
有关Matrix的详细介绍:硬件成本直降30%:PD 分离场景下的 AI 推理网络拓扑优化方案
测试项目和数据速览
01 E2E 转发性能测试
使用RDMA性能测试工具集(ib_write_bw)测试基于被测交换机组建的各网络架构下RoCE流量的转发性能。 该测试设置两个基准值
- 网卡背靠背直连(不经过交换机)测得任意一对网卡的转发带宽,作为 Matrix 基准。网卡采用400G bond 模式
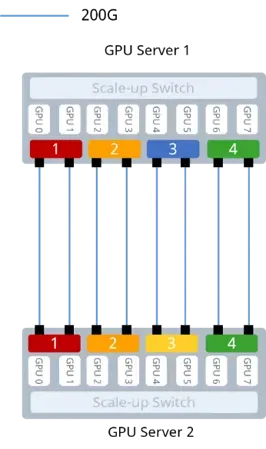
网卡背靠背直连测试拓扑
- 跨交换节点(经过单个交换机)测得任意一对网卡直连的带宽,作为 ROFT 组网的参考基线。网卡采用单口400G模式。
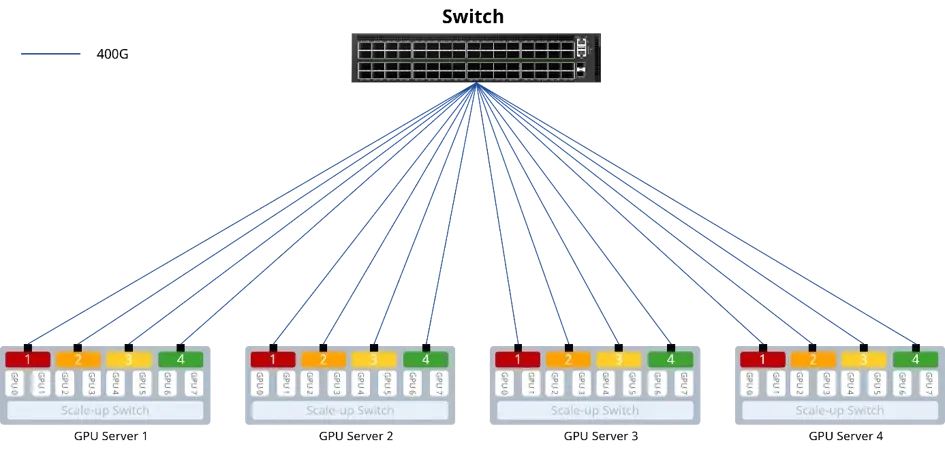
跨交换节点测试拓扑
测试结论
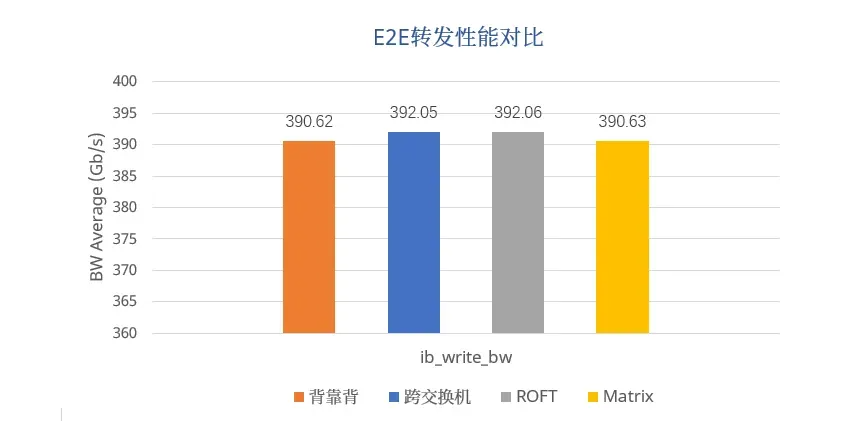
E2E转发性能测试中,ROFT 组网测得 392.06 Gb/s,与跨交换机参考基线 392.05 Gb/s基本一致;Matrix 组网测得390.63 Gb/s,与背靠背参考基线390.62 Gb/s基本一致。
测试结果表明,两种组网在各自对应的测试条件下均获得了接近参考基线的转发带宽。 由于两种组网采用的网卡工作模式及参考基线不同,本组结果不直接用于比较两种架构的相对性能优劣。
02 集合通信性能测试
该测试通过运行集合通信脚本验证基于被测交换机组建的各网络架构下的集合通信性能
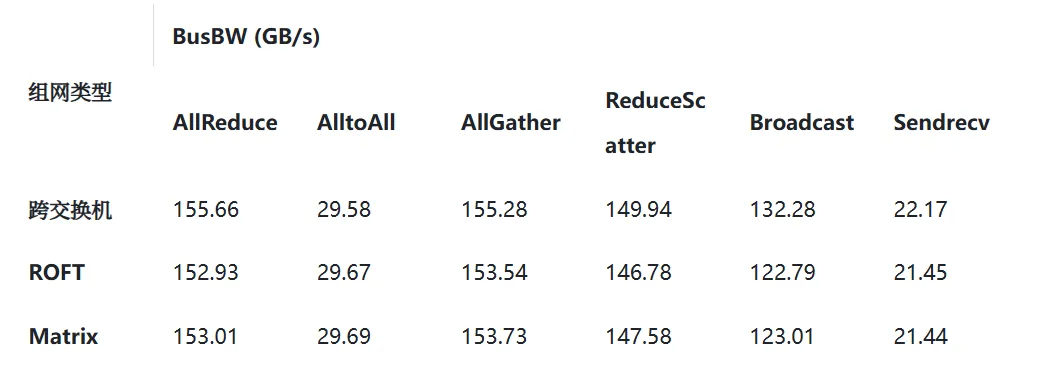
我们分别在两种不同组网架构下测试了多种集合通信模型,并对比参数调优前后的性能与基准测试的差异。测试选取 8G message size 下的总线带宽(out-of-place busbw)作为对比指标(单位为GB/s),主要关注 All-reduce 和 All-to-All 通信。
- 总线带宽 (BusBW,Bus Bandwidth):通常用于衡量集合通信操作中,算法实际传输的数据量相对于执行时间的效率,并结合通信算法的通信量折算为等效带宽
测试结论
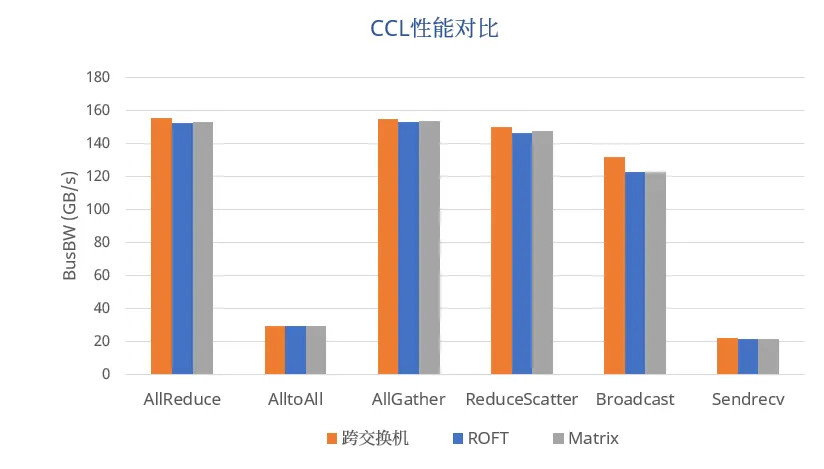
网络参数调优前:
针对Matrix组网进行参数调优后:
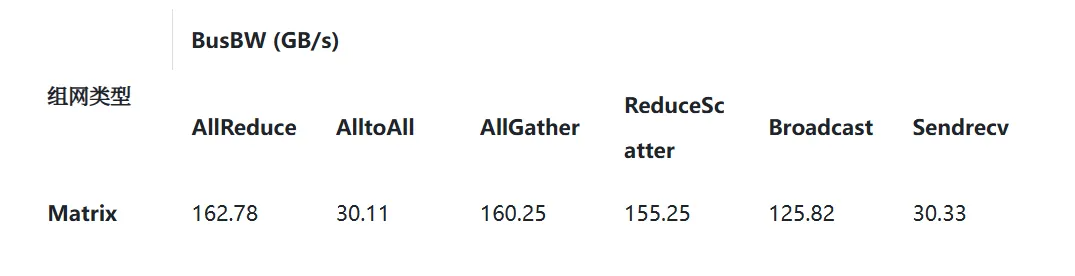
Matrix组网的All-Reduce和All-to-All测试结果与ROFT基本一致,表明Matrix在本次测试覆盖的集合通信负载下能够提供与ROFT相当的性能。
针对Matrix组网进行参数调优后,All-Reduce、All-to-All 等测试项的性能均得到进一步提升
03 模型推理测试
我们使用 DeepSeek-V4-Flash模型,共4节点32卡,以PD分离(2P2D)方式部署推理模型验证基于被测交换机组建的各网络架构下的性能。
测试包含16、32、64并发场景,关注测试集群的以下性能指标:
- 总吞吐量(token/s):指单位时间内所有并发推理请求共同产生的输出Token总数
- 首token时延(Time To First Token,TTFT):指从用户发送请求到模型生成并返回第一个Token所经历的时间,单位为 ms
- 每token时延(Time Per Output Token,TPOT):指生成输出序列时,平均每生成一个后续Token所需的时间,通常不包含首Token的生成时间,单位为 ms
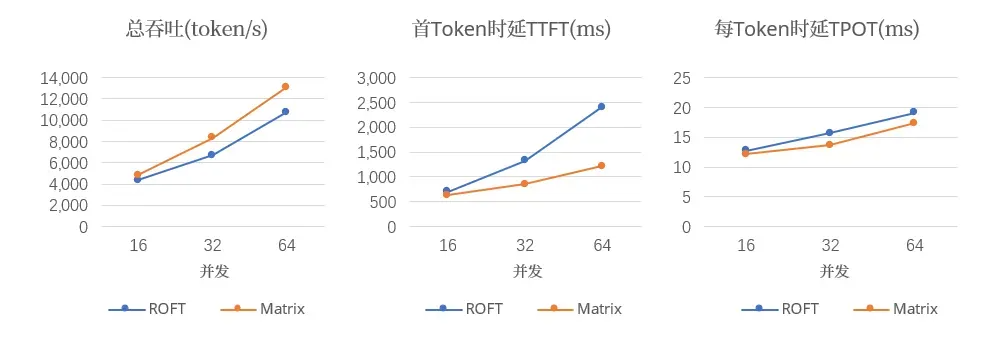
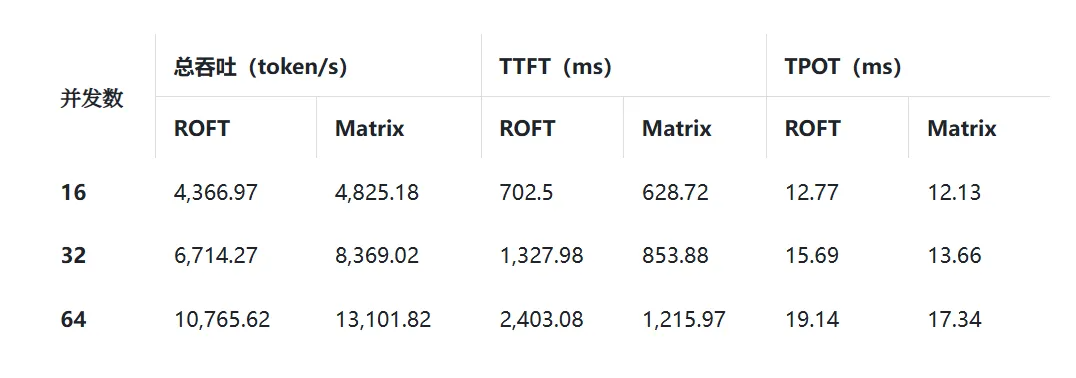
在DeepSeek模型推理测试中,Matrix架构展现出更高的总吞吐和更低的响应时延。
Matrix组网下并发64的总吞吐达到13,101.82 token/s,较ROFT提升21.7%;首Token时延(TTFT)降低约50%,每输出Token时延(TPOT)降低约10%。此外,根据方案配置对比,Matrix组网的网络硬件成本和整体功耗可降低约30%,具体收益以实际部署配置和测算结果为准。
依托星融元灵活的网络方案编排能力和端到端部署能力,可在短时间内完成从 ROFT 到 Matrix 的组网切换,快速完成网络部署、业务配置与参数调优,简化整体交付流程。相关信息参阅:AIDC 网络运维平台:自动化极简开局、RoCE 灵活调参和网络可观测
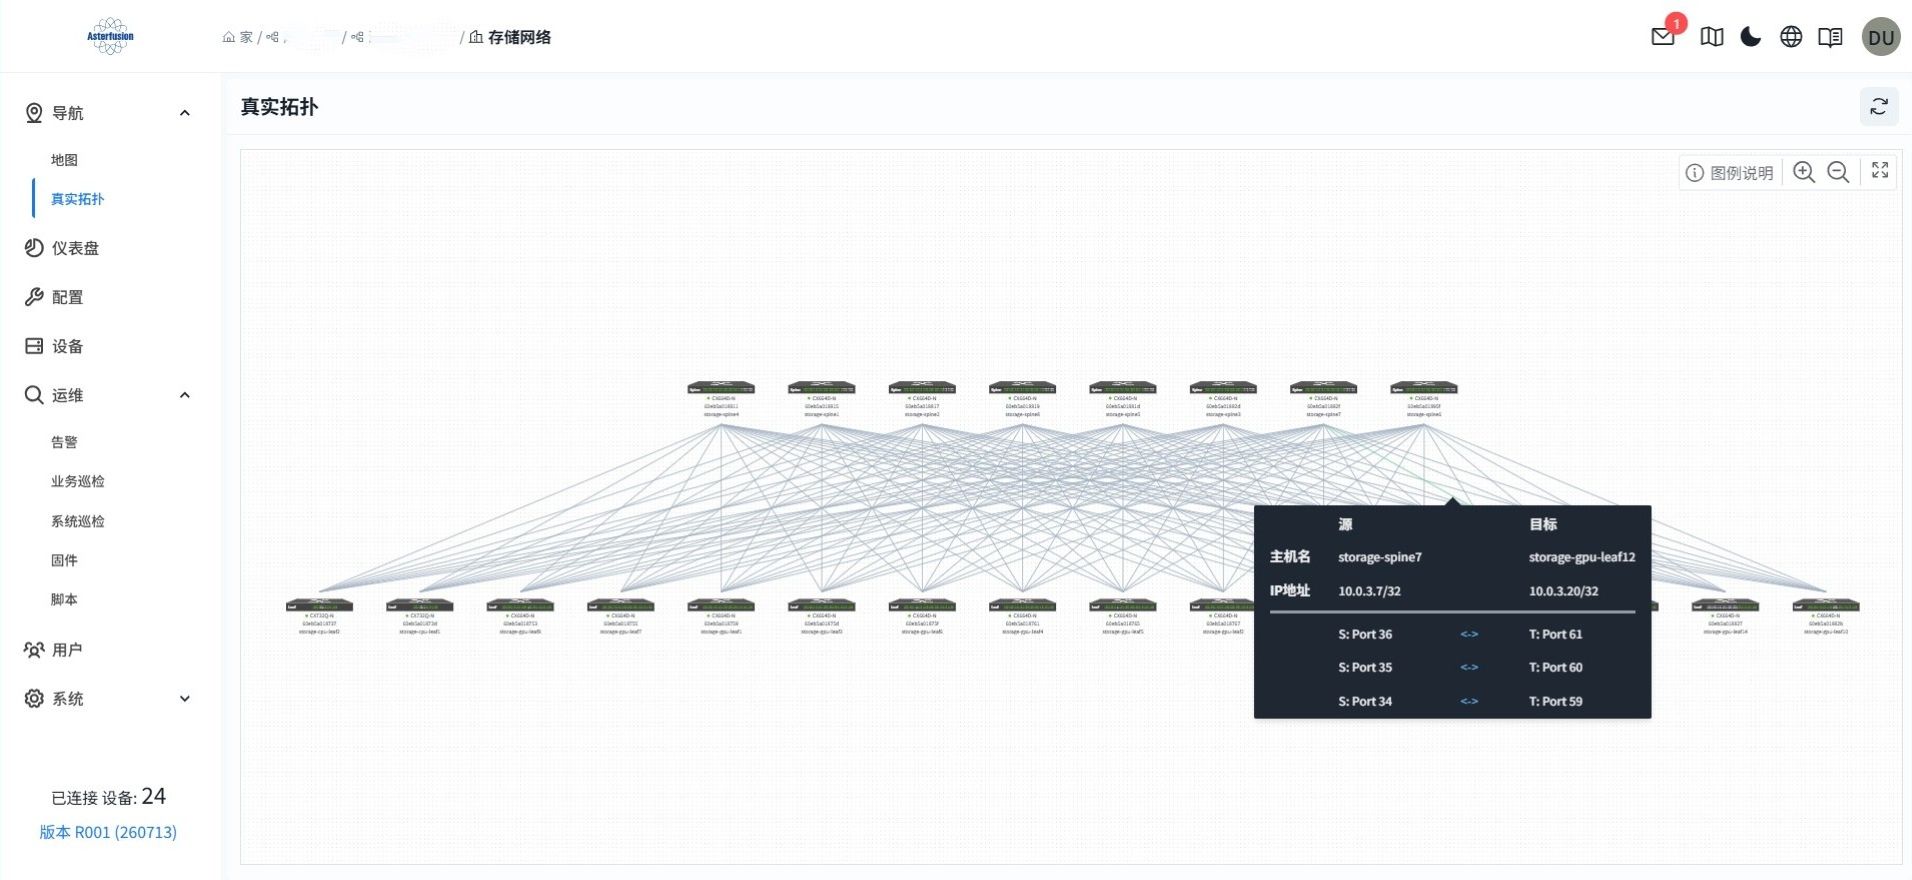
选型建议
总体而言,ROFT 和 Matrix 两种架构均可作为AI算力网络的组网选择,建议结合实际业务流量模型、性能目标和总体拥有成本等因素综合考虑。
优先考虑 AsterFabric ROFT
该架构与当前主流的AI集群网络设计实践具有较好的契合度,相关网络设计和工程实施经验较为成熟。
对于不熟悉业务模型,缺乏GPU集群及通信参数调优能力,且暂不具备联合调优条件的客户,建议优先选择ROFT,以降低方案实施和调优复杂度。
优先评估Matrix
对于以Prefill-Decode(PD)分离为主要部署模式、存在大量跨节点KV Cache传输的推理集群,可优先评估Matrix。
在相同GPU规模下,本方案的交换机数量较ROFT减少33%,可降低硬件部署成本。需要注意的是,Matrix组网架构在一定程度上提高了实施复杂度,对网络规划、线缆部署及后续运维提出了更高要求。
同时,要充分发挥其性能优势,还需要结合GPU集群部署、通信框架和推理业务特征进行联合调优。
附录:测试环境
交换机
计算节点
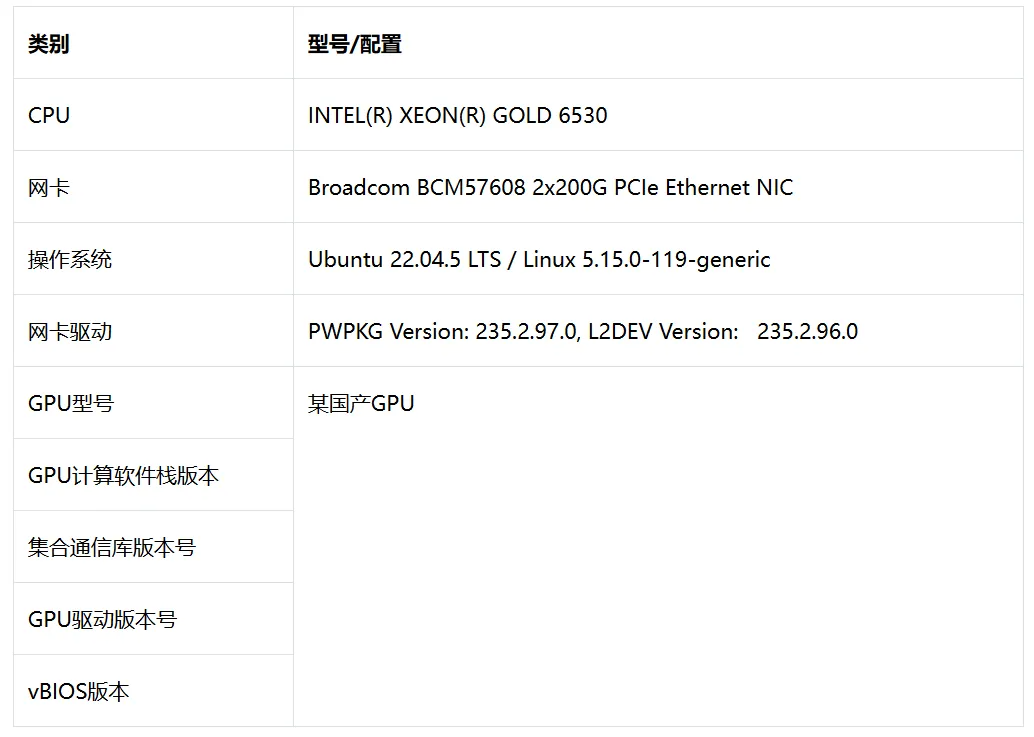
*了解计算节点相关信息,请与星融元业务代表联系。
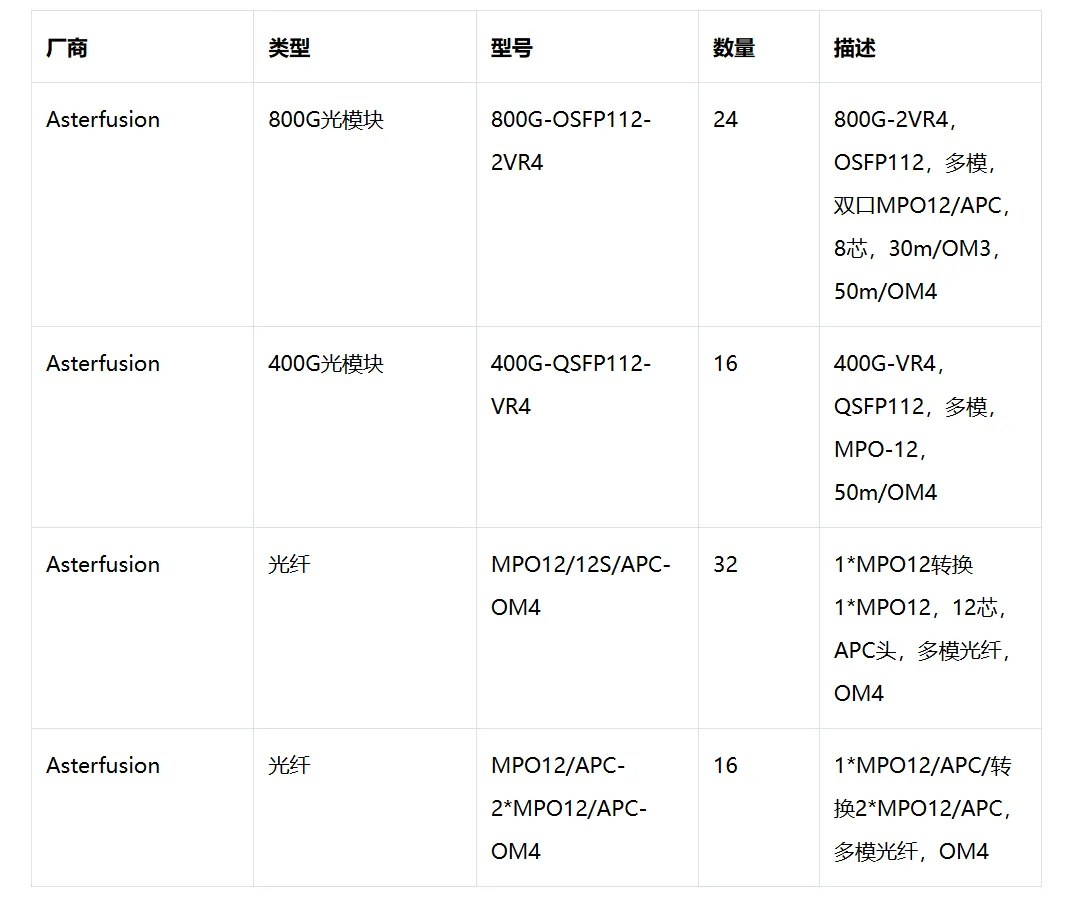
其他配件
产品型号: 星融元(Asterfusion)CX864E-N (64 x 800G OSFP)
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,分布式存储
最后更新:2026-05-18