开放网络的先行者与推动者—星融元
加入我们 | 技术支持(Support)  TEL:(+86)4000989811

标签: 技术分享

多厂商设备统一监控运维?基于OpenWiFi+LibreNMS的异构网络管理实践

LibreNMS分布式轮询与ACC控制器的深度集成,破解多厂商网络监控告警难题
OpenWiFi

异构园区网络管理中的现实挑战

实际生产网络环境中通常包含多样化的第三方 IT 硬件基础设施,例如出口安全网关、核心交换机和应用服务器,多厂商共存的现状带来了若干固有的运维瓶颈:

  • 控制平面与监控平面的割裂:运维人员被迫频繁在云管理控制台、厂商私有的网络管理系统(NMS)以及服务器监控平台之间切换,极大地增加了平均修复时间。
  • 数据孤岛,告警事件无法关联:不同系统采集的指标之间存在语义差异。由于缺乏统一事件关联规则,这些系统极易引发告警风暴,或无法有效识别关键的潜在故障。

开放网络之应对:OpenWiFi 控制器与 LibreNMS 的深度集成

星融元网络控制器(Asteria Campus Controller, ACC)基于开源的 OpenWiFi 框架构建,已原生支持符合 ucentral-client 规范的第三方无线接入点(AP)以及星融元(Asterfusion)原生网络设备的统一配置与监控。

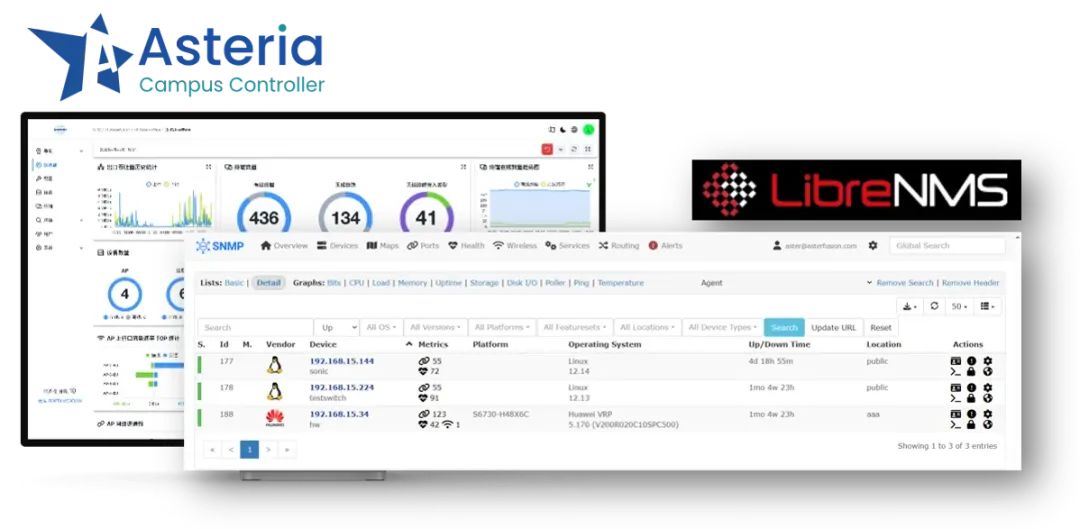
在此基础上,ACC 控制器利用标准化协议将 LibreNMS 监控引擎深度集成于控制平面下层, 实现企业多厂商网络资产的统一监控与跨平台运维协作。
OpenWiFi、LibreNMS

LibreNMS 是一款基于 PHP、MySQL 和 SNMP 构建的网络监控平台,其广泛的设备支持和内置 MIB 库构成了其在开源监控工具中的核心优势。经过全球众多企业级网络的实践验证,LibreNMS 是管理复杂多厂商网络环境的理想选择。

01 自动化子网扫描与设备发现

LibreNMS 引擎采用 ICMP 与 SNMP 发现机制的异步组合,实现设备的自动发现。管理员只需指定目标子网或 IP 范围,系统即可启动并行扫描。

对于活跃的主机节点,引擎尝试使用预先配置的 SNMP v1/v2c/v3 凭据建立会话,免去了逐个节点手动录入和凭据配置的过程,显著提升了大规模网络环境下的部署效率。

02 多厂商兼容性与指标自动提取

协议层的厂商兼容性与指标自动提取依赖于内置的系统指纹数据库和丰富的 MIB 映射表:

监控引擎自动解析 SNMP 的 sysObjectID;

根据检索到的 OID,系统自动将设备匹配至对应的厂商(如 Cisco、Juniper、华为、锐捷等)及操作系统类型;

匹配成功后,引擎会自动解析标准与私有 MIB 节点,提取关键性能指标(如 CPU 利用率、内存分配、接口吞吐量以及光收发器收发光功率);

03 事件驱动的告警处理机制

引擎支持自定义告警事件与阈值配置,持续将最新轮询到的数据与活跃告警规则进行比对。

当指标触发阈值条件时,事件 Agent 会构建标准化的告警 Payload,并通过集成的 SMTP 组件独立分发至管理员邮箱,避免告警交付过度依赖上层管理平面。

性能优化:分布式轮询,轻量化集成

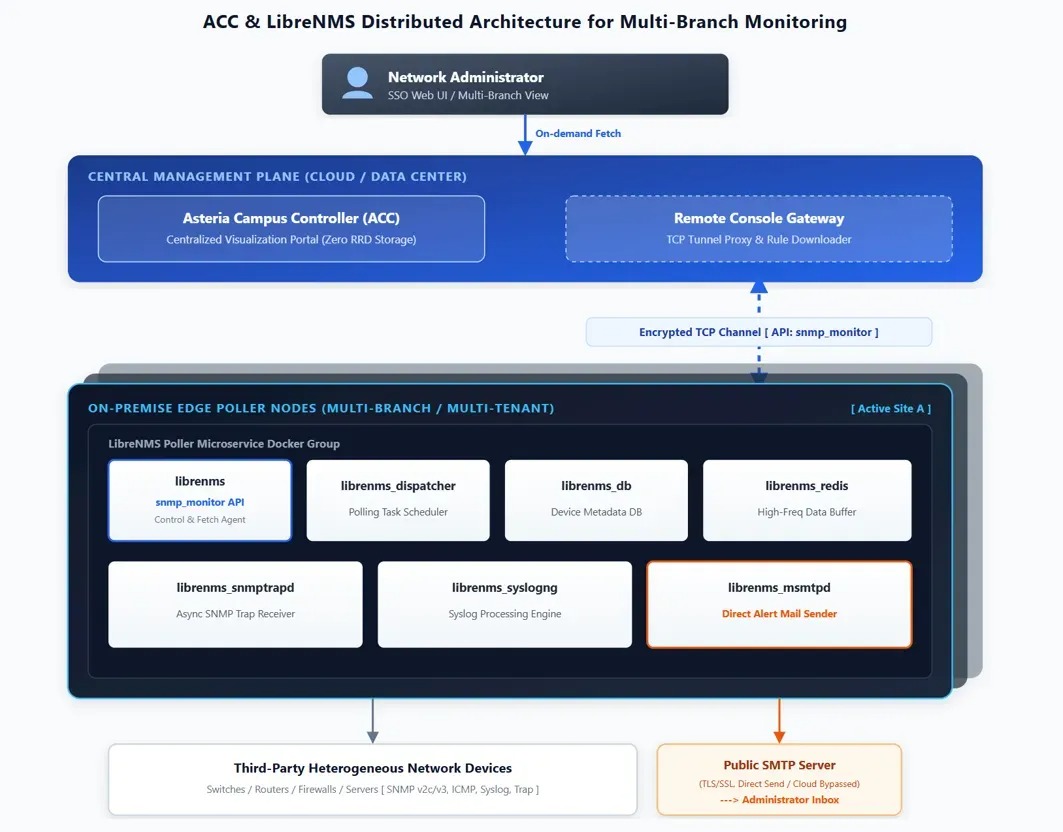
为了适应从本地到云端的不同部署场景,并支持多租户、多站点的控制器架构,ACC 采用了基于分布式轮询的轻量化集成架构。
LibreNMS
多租户/站点场景的集成架构

1. 云端控制中心(ACC Control Center)

LibreNMS 核心管理 Agent(Gateway Agent)作为轻量化插件封装于 ACC 网络控制器系统镜像内部,部署于公有云或集中数据中心。

控制中心提供统一的 Web 可视化门户,但并不直接执行高频的 SNMP 数据轮询,也不持久化存储原始接口性能指标或轮询数据库图表文件。

当运维人员通过 Web UI 请求特定站点的监控状态时,ACC 控制中心通过 API 代理映射向对应本地网络的 Edge Poller 节点发起按需请求(On-demand Request),从而完成实时数据的检索与渲染。这种方式大幅降低集中控制器的计算与 I/O 负载。

2. 边缘轮询节点(librenms-poller)

librenms-poller 是部署于企业内网或分支机构内部的自主边缘采集节点:

本地轮询与存储:节点在本地通过 SNMP v2c/v3(UDP 161)或 ICMP 协议对第三方设备执行定期轮询,并将时序数据直接写入本地 RRDCached 缓存服务及 RRD 文件。本地化数据存储极大地减少了传输原始监控数据所需的广域网(WAN)带宽消耗。

断网自愈与连续性:当边缘节点与云端 ACC 控制器之间的管理链路因网络波动中断时,Edge Poller 仍可依托本地数据库和 RRD 文件自主运行,确保监控数据的连续记录不中断。

负载分担:这种分布式部署与集中化管理的模式确保了在多分支场景下,各节点的轮询负载完全由本地计算资源承担,从而消除了大规模网络中集中式网管平台常见的 CPU 及磁盘 I/O 瓶颈。

3. 本地告警引擎与独立分发

librenms-poller 节点内置独立的告警评估引擎。在接收到来自 ACC 控制器的告警规则后,节点会在本地轮询周期内持续评估实时数据。一旦触发告警阈值,Edge Poller 节点可直接与公网 SMTP 邮件服务器建立加密连接进行发送,无需依赖云端控制器进行中继转发。

配置流程与运行效果

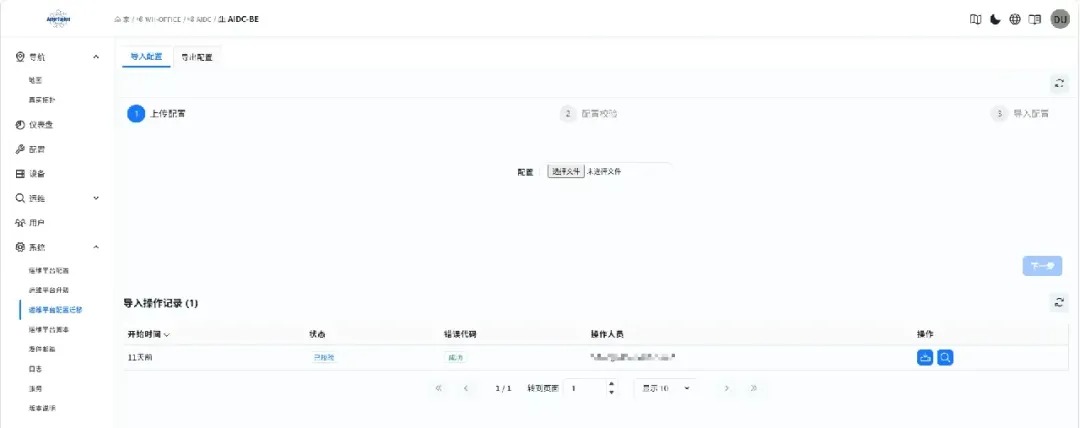
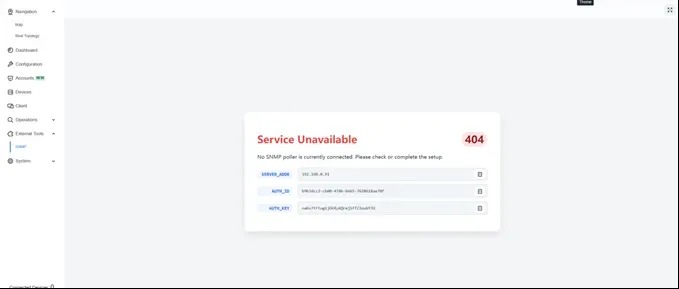
在部署过程中,管理员需配置凭据参数,包括服务器地址(SERVER_ADDR)、认证标识(AUTH_ID)以及安全密钥(AUTH_KEY)。

1、节点注册与绑定:执行本地 snmp-poller 部署时,上述参数将被注入边缘节点配置中。随后,节点通过加密 TCP 通道向控制中心注册,完成逻辑上的站点绑定。
snmp-poller

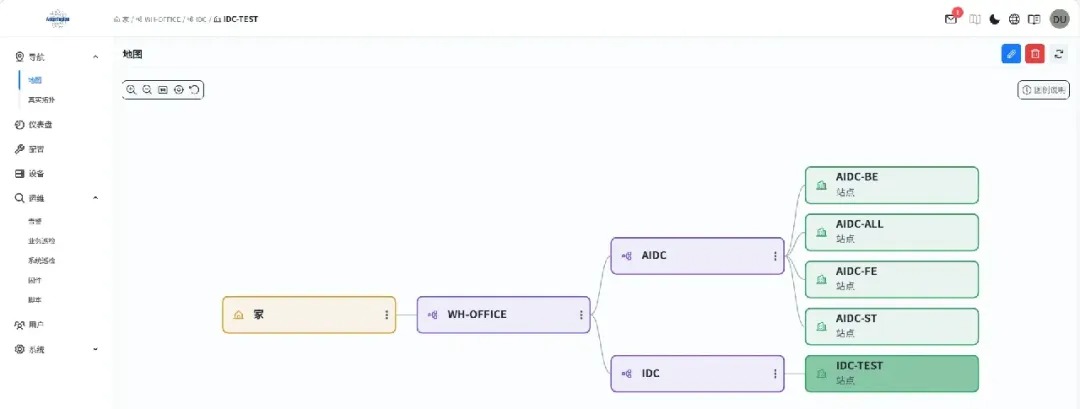
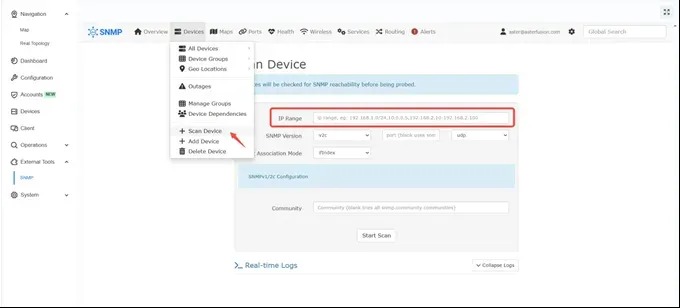
2、任务下发与同步:绑定建立后,管理员可直接在 ACC 云端控制台发起子网发现任务。Edge Poller 完成扫描后,设备资产清单及状态元数据将同步至控制器 UI。
Edge Poller

SNMP

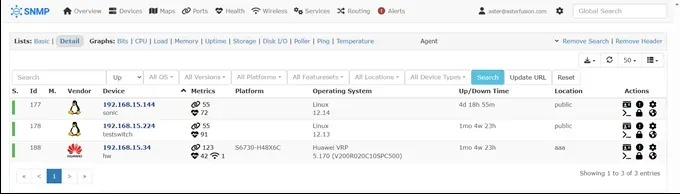
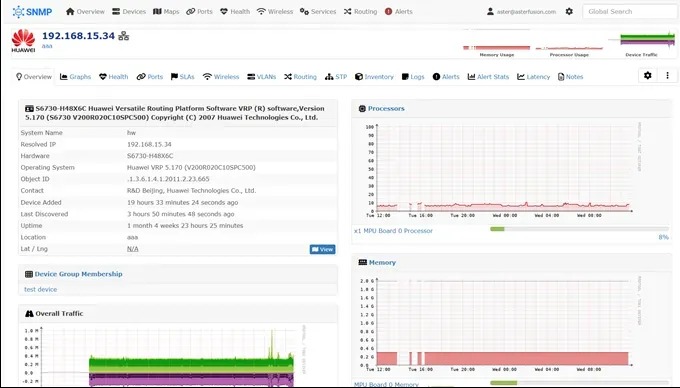
3、实时数据呈现:点击特定设备后,控制中心会向 Edge Poller 发起 snmp_monitor API 调用,动态拉取实时时序图表(CPU、内存、流量吞吐量)。示例图为华为S6730设备。
控制器

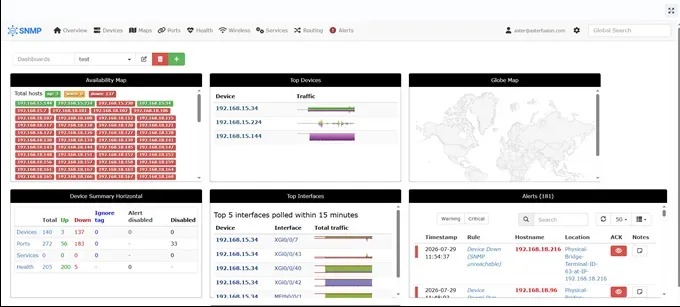
平台允许管理员使用全局指标小组件构建自定义 Dashboard,包括设备可用性热力图、Top-N 接口流量分布图以及高时延节点图。
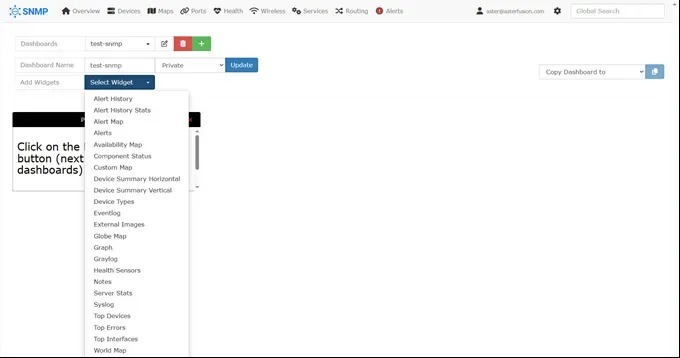
SNMP

SNMP

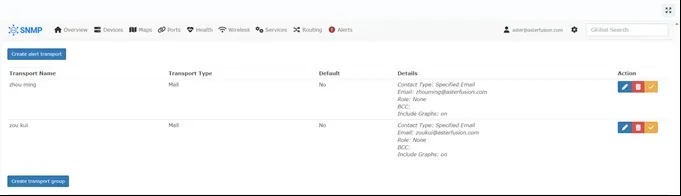
4、告警规则映射:在告警配置模块中,可灵活定义条件表达式(如接口 Down、CPU 利用率超限等)并映射至指定的邮件传输组,实现跨异构网络资产的精准事件分发与协同应急响应。
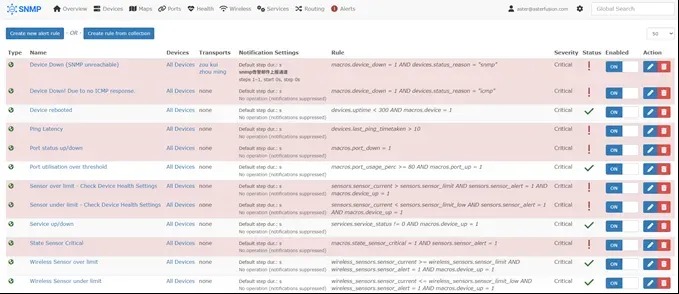
SNMP

SNMP

结语

通过深度集成 LibreNMS 工具并采用分布式轮询架构,Asteria Campus Controller (ACC) 打通了原生 OpenWiFi 架构与传统第三方网络设备之间的壁垒,为企业构建具备高扩展性、高可靠性及低带宽消耗的统一异构网络运维体系提供了坚实的技术支撑。


产品型号:云化园区交换机
功能特性:DHCP Snooping,动态ARP检测,ND Snooping,IPSGv4/v6,PTP……
应用场景:校园网,企业网,分布式网关,网络接入认证……
最后更新:2026-05-22…

相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

产线效率跃升超一倍!星融元助力工业制造企业打造产品老化测试与出货网络

双轨 Leaf-Spine 架构破解 10G 拥塞瓶颈——25G/100G 大带宽升级、毫秒级 SNMP 响应与统一集中纳管,驱动老化测试与出货烧录效率翻倍

工业网络、案例、asterfusion

客户 YL 是国内专注于高端计算设备制造、整机集成与行业数字化解决方案的高科技制造企业。在服务器整机装配与出厂环节中,自动化老化测试与批量出货烧录是检验整机硬件稳定性、保障交付质量的关键环节。

背景

为了大幅削减人工插拔、手动对单和分散测试带来的工时浪费,YL 联合自动化老化机架厂商,在生产车间投建了全新的智能化、自动化服务器老化与测试生产线。

生产规模与产线布局

  • 一期规划 4 条独立生产线;
  • 每条产线配备 11 个自动化服务器老化架;每个老化架采用 4 层立体结构,单架配置 88 个测试机位 与 2 台 Leaf 接入交换机;
  • 单条产线并发支持近千台(968 个)待测节点,全期四条产线机位容量近 4000 个,共计部署80余台接入交换机。

物理位置自动识别与智能灯带

  • 老化架每层均配备 1 个嵌入式智能控制板,用于驱动贯穿机架的红、黄、绿三色高亮 LED 状态灯带,分别对应着程序执行中、功能项未通过和全流程测试合格;
  • 待测服务器通电开机后,自动化测试脚本自动发起 SNMP 协议查询,向接入交换机实时获取本机所在的物理接口索引及 LLDP 拓扑信息,并将本机物理坐标与测试执行状态实时上报给嵌入式控制板。

高吞吐业务流

  • Download Test(DL 测试):整机硬件组装下线后,待测服务器批量通过 PXE 引导从测试服务器拉取定制精简版测试系统镜像(单个约 10GB),启动并自动拉取压测工具与老化控制脚本。
  • Download Shipment(DL 出货):整机老化合规后流转至出货区,通过 PXE 批量烧录包含全套商业操作系统、驱动程序及客户业务环境的正式出厂镜像(单个达 20GB)。

业务挑战

随着 YL 产线批量化交付订单的井喷,原有的企业网架构在面对工业级高密并发时成为严重的“生产交付瓶颈”:

1. 瞬时突发流量剧烈,原有 10G 上联链路长期打满

  • 300 台并发下载瞬间触发数倍于 10G 链路物理容量的流量突发;
  • 交换机上联端口利用率长期死锁在 100%,引发恶性丢包、严重排队抖动和 TCP 指数退避重传;
  • 镜像拉取耗时漫长,甚至引发大规模 TFTP/PXE 连接超时异常,产线工人经常需要手动复位、人工重测,严重阻碍生产流转。

2. 高频 SNMP 定位受阻,自动化灯带状态滞后误报

  • 交换机缺少精细化的 QoS 队列调度与 CPU 保护机制,SNMP 控制报文被大量排挤丢弃,导致嵌入式灯带无法及时亮起黄色或误报红灯,产线自动化调度系统频繁告警。

3. 设备点多面广,缺乏集中化的控制器与流量可视化能力

  • 一期 4 条产线共计分布 88+ 台接入交换机。在传统网管模式下固件升级、VLAN 划定、ACL 策略变更全凭工程师逐台 CLI 登录配置,维护难度大、配置易出错;
  • 缺少纳秒级硬件遥测手段,网络出现偶发微突发丢包时无法精准追溯与定界定位。

星融元改造方案

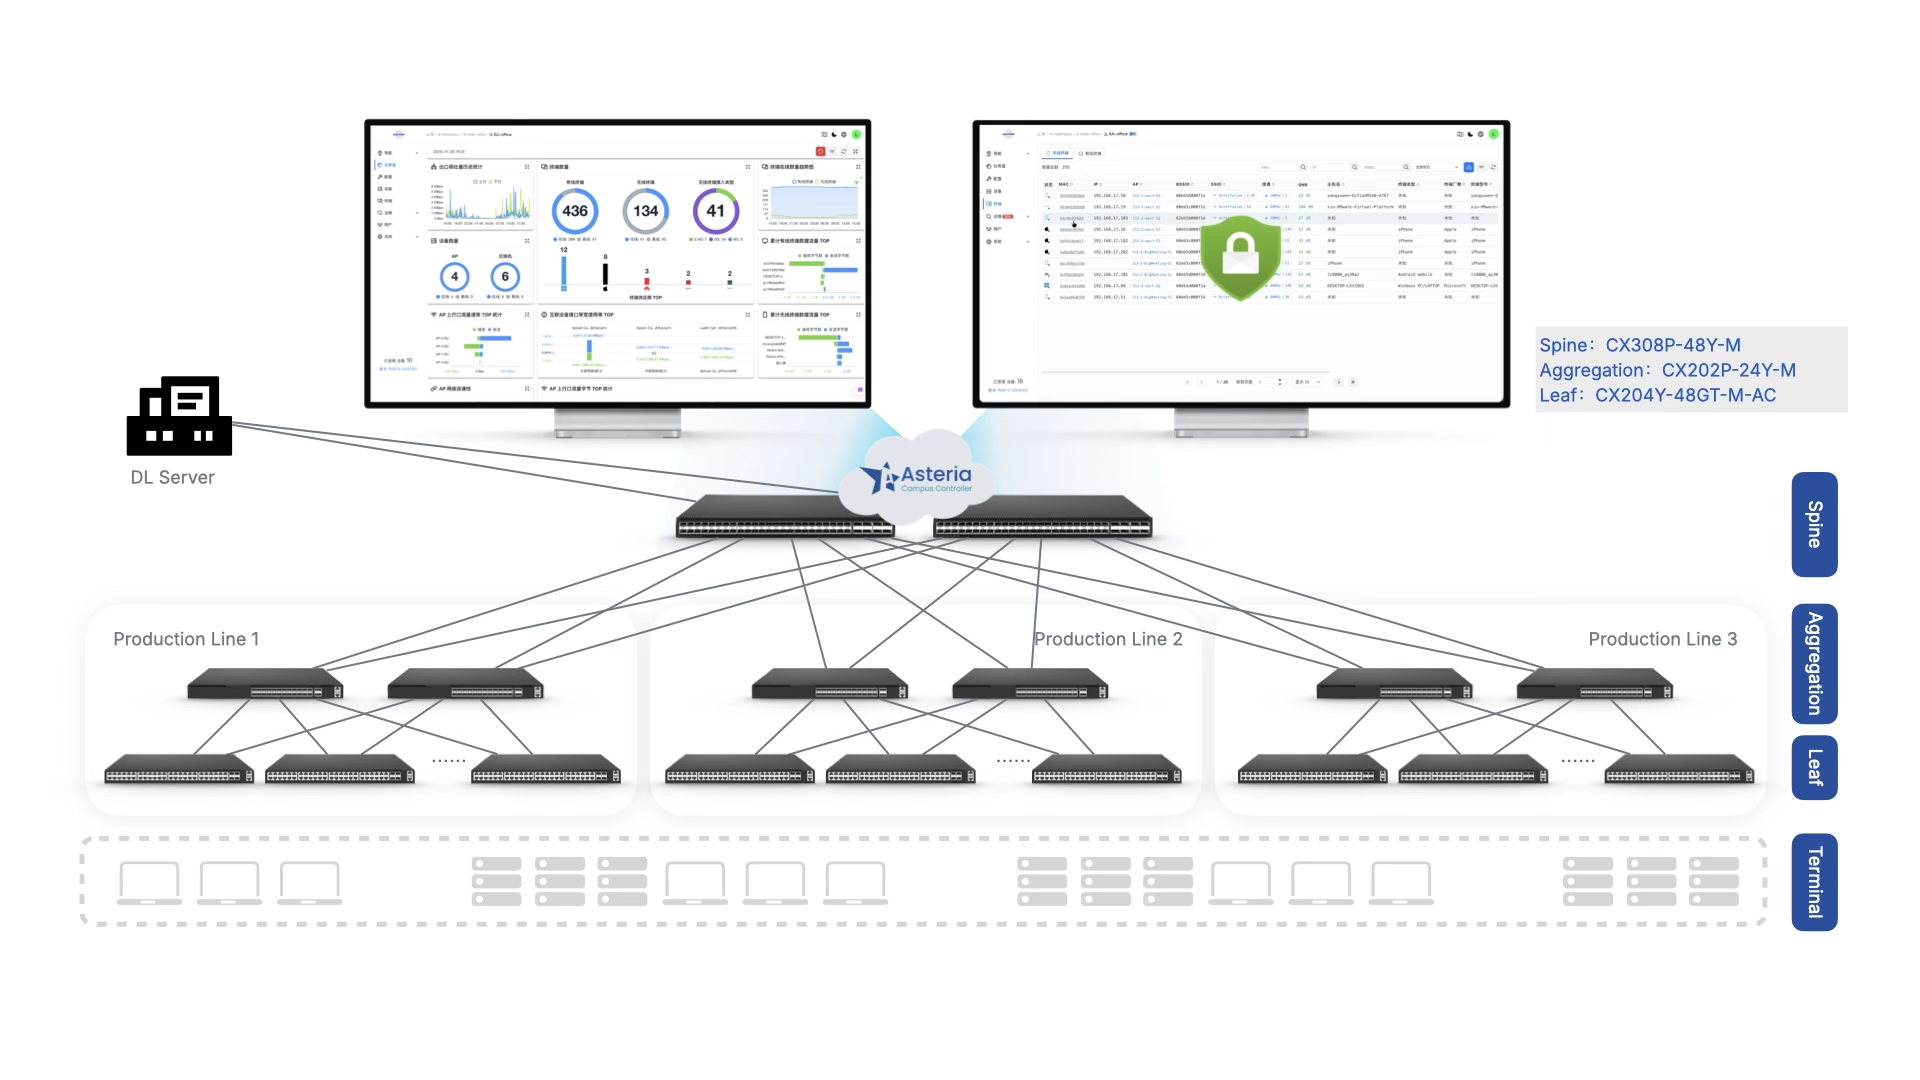
针对客户对于高吞吐、零丢包、低时延和高安全集中纳管的严格诉求,星融元基于自主研发的企业级网络操作系统(AsterNOS),为 YL 打造了高可靠、大带宽、集中控制的双轨 Leaf-Spine 自动化制造网络架构。

服务器老化与测试生产线

升级 25G/100G,彻底根除带宽瓶颈

方案将产线划分为 DL1 测试集群 和 DL2 出货集群,两个业务域流量完全隔离、互不影响;仅部署管理网与原有企业网络打通,并增加了访问控制策略,确保核心网络与生产网络的安全隔离。

服务器端以 100G 汇入 Spine,Leaf 接入层以 25G 上联,实现了端到端带宽的阶梯式匹配。即使 300 台设备在同一秒发起 PXE 请求,网络也能提供平滑的缓冲吸纳与高速线速转发,彻底杜绝拥塞重传。

  • Spine 核心层:

部署 2 台星融元 CX308P-48Y-M 高性能数据中心级交换机,提供高密 25GE/100GE 交换能力;通过 100G 链路直连 DL 测试 PXE 服务器,确保源端镜像输出带宽无阻碍。

  • Aggregation 汇聚层:

部署星融元 CX202P-24Y-M 高性能交换机作为汇聚节点,承载 Spine 核心大容量流量,并向下提供高密 25G 汇聚分发,提供充足的端口扇出能力,满足 4 条产线数十台接入交换机的高并发汇聚需求。

  • Leaf 接入层:

部署多台星融元 CX204Y-48GT-M-AC 交换机,单台提供 48 个千兆电口直连老化架机位,上行采用 25GE SFP28 高速链路双归双上联至 Spine 交换机,将接入层上行带宽由原先的 10G 直接扩容到 25G/50G。

SNMP 栈优化,确保自动化灯带“零秒差”精准响应

星融元交换机搭载优化的系统协议栈,在处理密集突发流量的同时,保障管理平面与 SNMP 查询队列的高优先级调度(CoPP / QoS)。

待测服务器执行脚本反查交换机端口位置时,SNMP 请求能在 30ms 内完成回包,嵌入式控制板与黄、红、绿三色灯带实时精准响应,杜绝漏判误报。

引入星融元统一网络控制器

在汇聚层旁路部署集中式网络控制器,打通了对整网交换机的统一纳管:

  • 自动化下发与配置管理:支持一键批量推送 VLAN、QoS、端口限速及镜像策略,新上架 Leaf 即插即用;
  • 高精度流量监控与遥测(Telemetry):全天候收集端口利用率、缓冲区队列深度、丢包计数等微突发指标,帮助运维人员告别黑盒盲区。

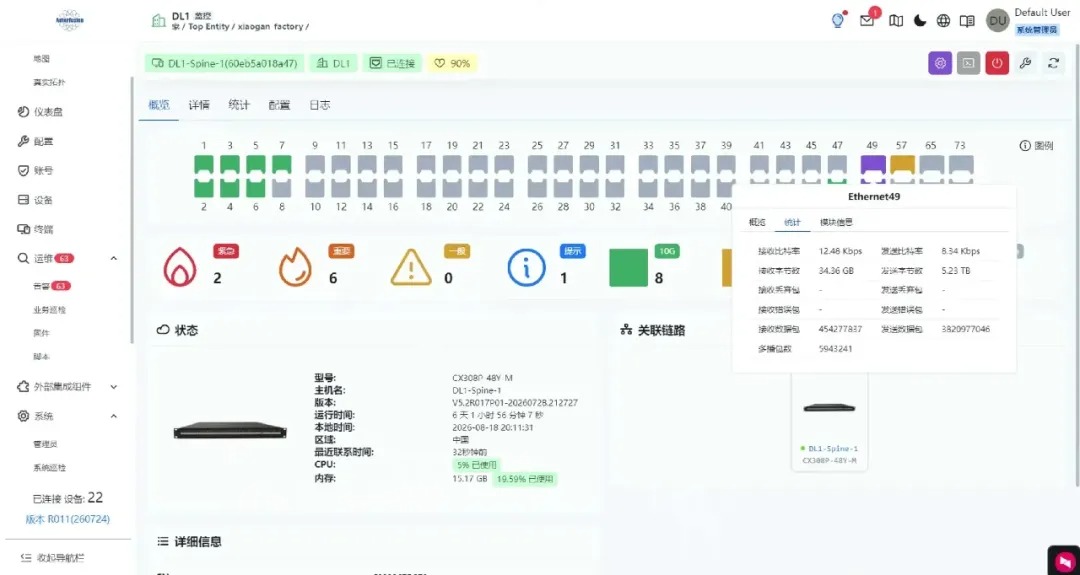
ACC dashboard

改造前后性能实测

在 200~300 台并发满载运行场景下,我们进行了升级前后的性能实测对比,数据如下:

改造前,100 余台终端并发拉取 20GB 镜像时,单机分摊的平均下行带宽不足50Mbps,更伴随严重的丢包重传恶性循环,导致总耗时逼近40分钟。 改造为 25G Leaf 上联 + 100G 源端 Spine 汇聚后,网络有效吞吐能力被彻底激活,单批下发耗时缩减至15分钟以内,真正兑现了产线效率加倍目标。

评估指标 / 业务场景 改造前 改造后
DL 测试镜像(大小约 10GB) 18分30秒(高峰拥塞时达 22~25 分,偶发超时) 7分15秒(线速稳定下发,无任何超时)
DL 出货镜像(大小约 20GB) 38分40秒(10G 上联持续打满,重传严重) 15分50秒(全线速下载,整批平稳烧录)
300台高并发下载成功率 87.5%(约10~15%节点需人工重启重测) 100%(首轮启动一次性通过)
SNMP 位置查询响应时延 800ms~3500ms(并发下偶现丢包超时) 30ms(稳定毫秒级回包响应)

改造前,100 余台终端并发拉取 20GB 镜像时,单机分摊的平均下行带宽不足50Mbps,更伴随严重的丢包重传恶性循环,导致总耗时逼近40分钟。

改造为 25G Leaf 上联 + 100G 源端 Spine 汇聚后,网络有效吞吐能力被彻底激活,单批下发耗时缩减至15分钟以内,真正兑现了产线效率加倍目标。

项目收益总结

交付流转能力翻倍:原本长达近 1 小时的批量镜像部署压缩至 20 余分钟,整机流水线工时缩减,为大规模订单的准时履约提供坚实支撑;

“硬件-网络-机位-灯带” 实现可靠闭环:毫秒级响应的 SNMP 栈与高优先级 QoS,确保自动化测试定位零差错,提升了工业控制与灯光联动逻辑的可靠性;

极简智能化集中运维:告别单机手动命令的陈旧模式,统一控制器打通80余个网络节点的自动化纳管与精细化遥测,运维效率提升 70% 以上;

平滑扩展与开放兼容:基于开放网络架构搭建,未来二期、三期产线扩建机架时可无缝横向扩展,保护企业长远投资。

相关阅读


产品型号: 星融元(Asterfusion)ET3600系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……
应用场景:企业路由器,路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


产品型号: 星融元(Asterfusion)ET2500系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……

应用场景:路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

SRv6 DCI 跨域互联:构建AI时代端到端纯 IPv6 云网融合基础设施

Option A/B/C 跨域架构解析:从 VXLAN-MPLS 孤岛走向统一 IPv6 平面的端到端流量工程

SRv6 DCI

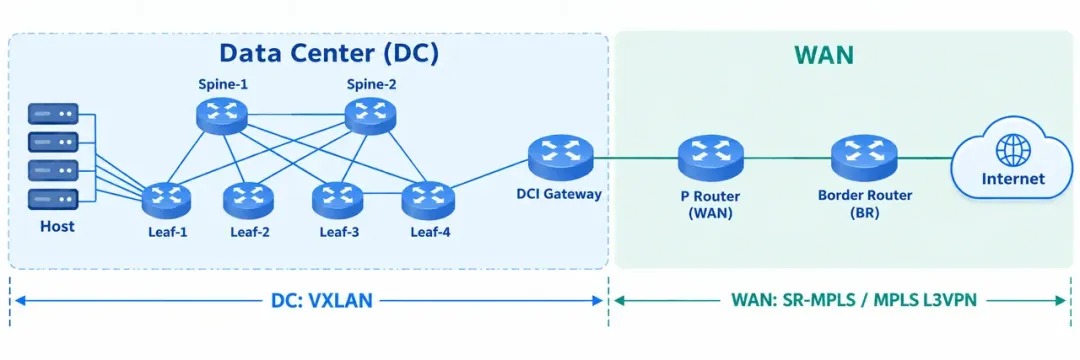
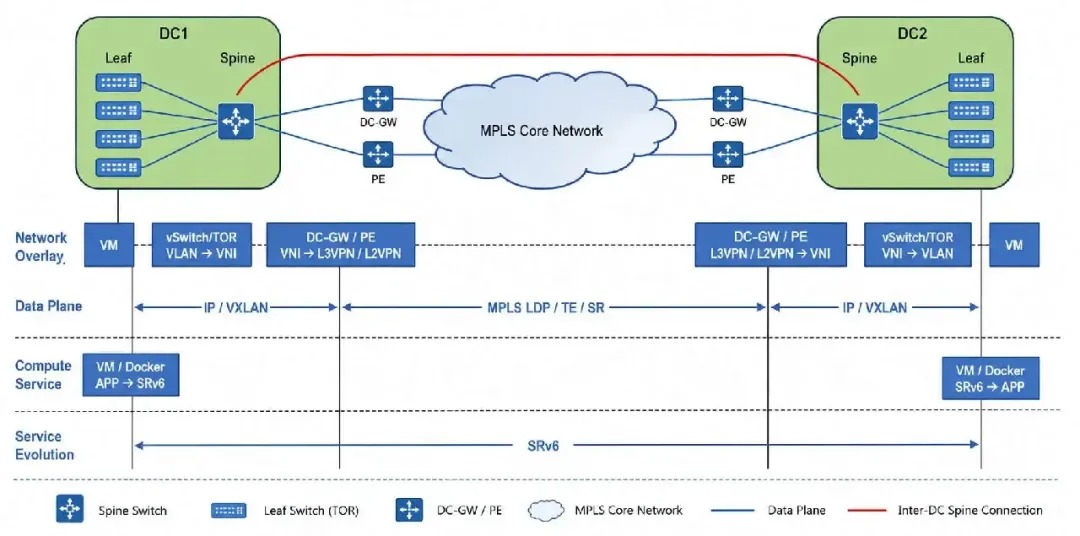
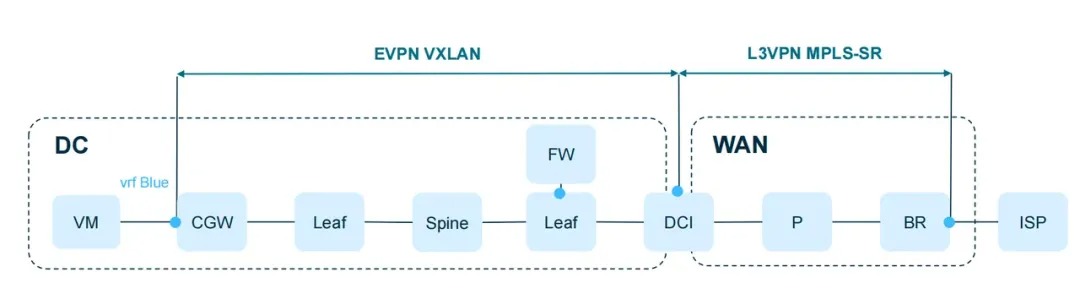
传统的企业与云网中,数据中心内部网络(通常采用 VXLAN )与外部广域网(WAN)被划分为相互割裂的技术孤岛.这种“内部 VXLAN + 外部 MPLS” 导致数据中心与骨干网之间存在明显的技术栈与管理方式割裂。

例如:数据中心边界设备需要同时运行两套完全不同的控制平面与数据平面,必须进行复杂双向协议转换(VXLAN ⇋ SR-MPLS / MPLS L3VPN),并且维护全网的 VRF 路由状态,容易成为扩展性瓶颈与单点故障源。此外,跨域网络状态丢失,以及边界安全服务链架构的僵化也对云网的扩展性造成阻碍。

数据平面

随着 AI 大模型训练、边缘计算的发展,跨 DC 的分布式算力调度(如 GSE-DCI、智算中心互联)对网络的极高吞吐、极致低时延和灵活的动态接入能力提出了更高要求。

SRv6 DCI 通过统一 IPv6 平面,实现了架构归一、端到端流量工程与随路检测,为智算与云网融合奠定了极简高效的底座。

有关SRv6相关介绍参阅:下一代数据中心网络重构:从 EVPN-VxLAN 走向端到端 SRv6 Fabric

SRv6 DCI 跨域模式

当前SRv6 DCI 跨域模式主要有Option A、B、C三种。

Option A(VRF-to-VRF 背靠背方式)

  • 控制面:两个自治系统的 ASBR 之间通过物理链路或 VLAN 子接口直连,每个子接口绑定到一个独立的 VRF(虚拟路由转发)实例。ASBR 之间运行普通的 IPv4/IPv6 或 BGP 单播协议,互相学习对方 VRF 的路由。在 ASBR 看来,对端的 ASBR 就像是自己连接的一个普通 CE(客户边缘)设备。
  • 数据面:数据包到达本域 ASBR 后,彻底解封装掉外层的隧道(MPLS 标签或 SRv6 SID),还原为普通的纯 IP 报文;随后根据子接口绑定的 VRF 路由表转发给对端 ASBR,对端 ASBR 接收后重新打上其域内的隧道头。
  • 优点:配置简单,隔离性极高,各域独立运维。
  • 缺点:可扩展性极差。每个 VPN 租户都需要在 ASBR 间占用一个接口/VLAN,且 ASBR 需要感知并存储所有租户的 VPN 路由,硬件开销极大。

VRF-to-VRF

Option B(ASBR 间 MP-eBGP 路由与标签/SID 交换)

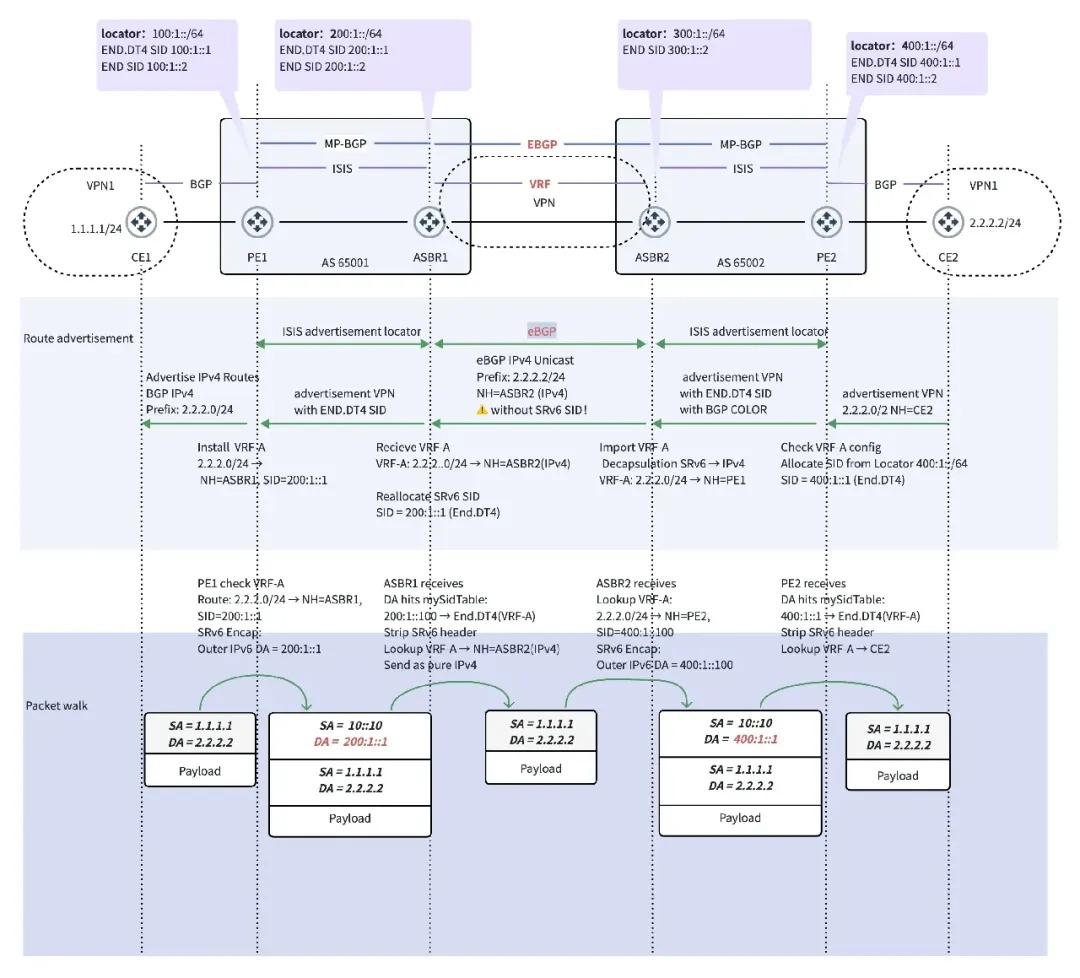
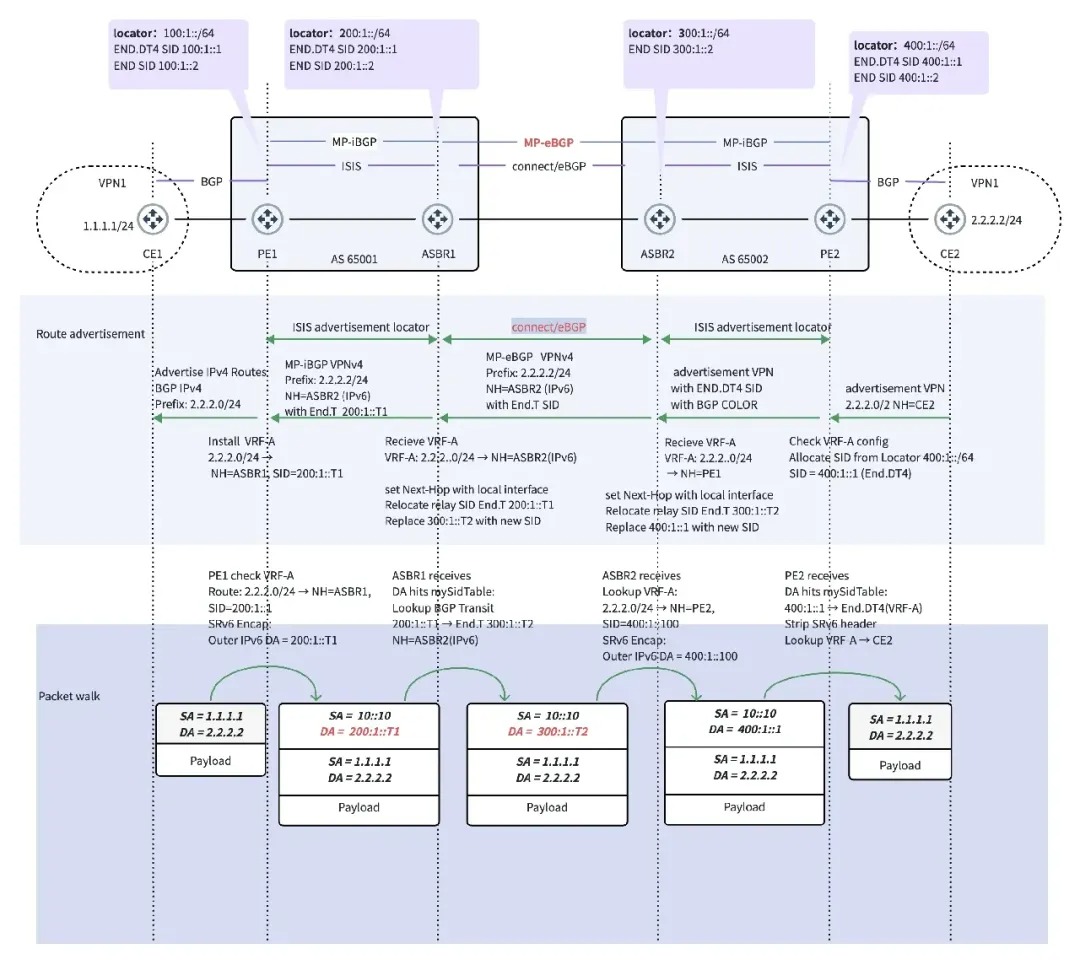
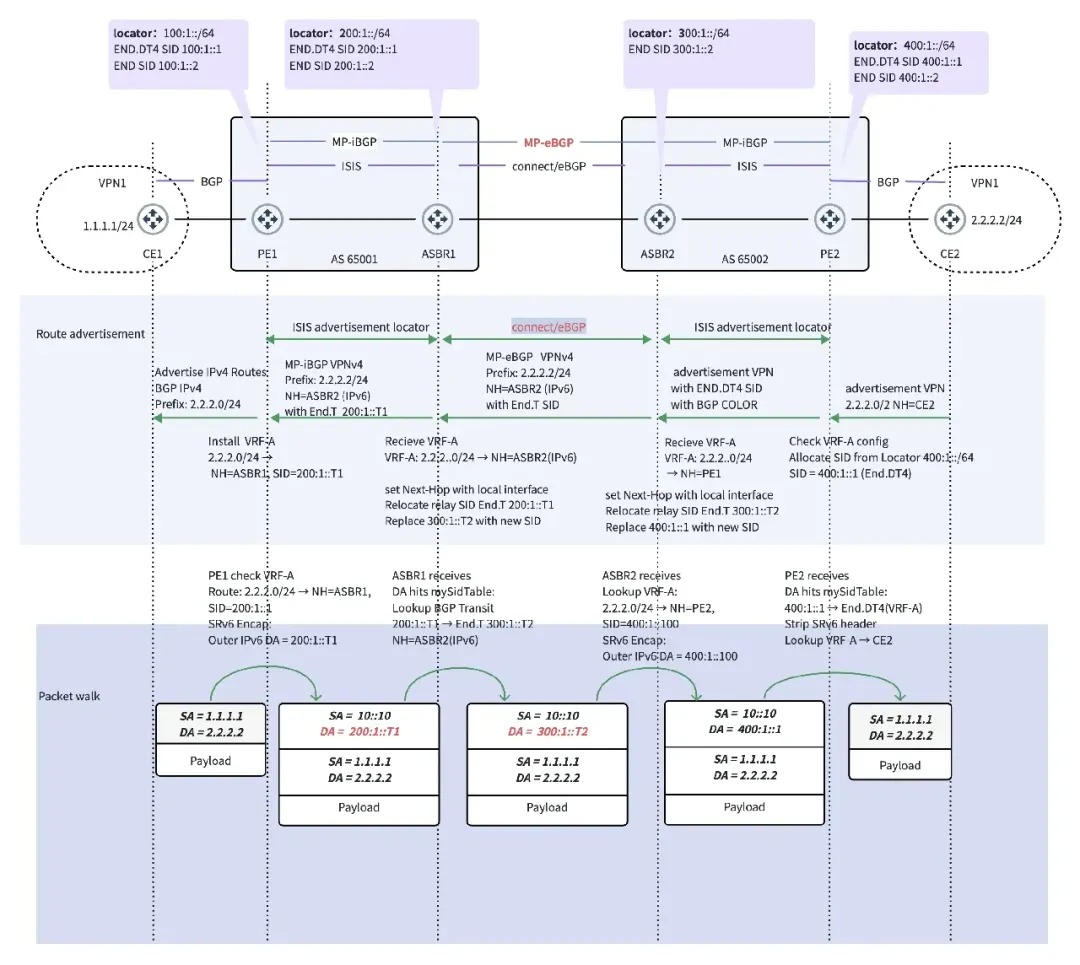
  • 控制面:本域 PE 与 ASBR 建立 MP-iBGP 邻居,ASBR 之间建立 MP-eBGP 邻居。VPN 路由在 ASBR 之间直接传递。ASBR 在转发 VPN 路由时,会修改下一跳为自身,并重新分配一个新的标签/Binding SID。
  • 数据面:数据包跨域时,ASBR 不需要解封装至内层 IP/VRF 级别。在 MPLS 中表现为 标签替换(Label Swap);在 SRv6 中,报文的目的地址(Outer IPv6 Dip)会被替换为对端 ASBR 宣告的 Binding SID / Cross-Connect SID。
  • 优点:无需在 ASBR 间为每个租户划分子接口,扩展性优于 Option A。
  • 缺点:ASBR 仍然需要保存和维护所有跨域 VPN 的路由明细,当租户数量巨大时,ASBR 内存压力依然较重。

ASBR 间 MP-eBGP 路由与标签/SID 交换

Option C(端到端 PE 间 MP-eBGP,路由穿透)

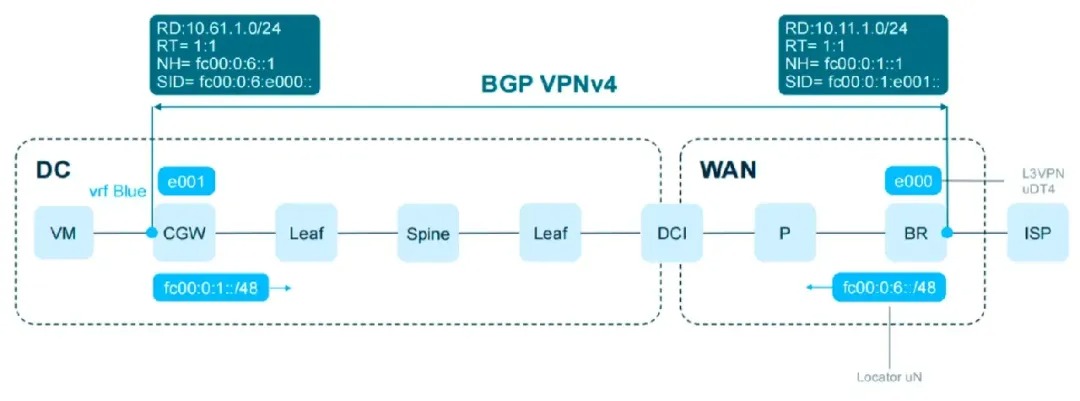
  • 控制面:跨域的源 PE 与目的 PE 之间直接建立多跳(Multi-hop)MP-eBGP 邻居,直接端到端交换 VPN 路由信息。ASBR 节点完全不感知任何 VPN 路由,它仅需要通过 BGP(IPv4/IPv6 或 BGP-LU / SRv6 Locator)相互宣告各自域内 PE 节点的Loopback / Locator 地址,实现底层路由互通。
  • 数据面:端到端建立一条贯穿两域的隧道。数据包直接打上目的 PE 的标签/SID,ASBR 仅负责纯粹的底层公网路由转发或标签/SID 的外层转接,不对报文做任何业务层的解封装。
  • 优点:ASBR 性能瓶颈被彻底释放(只需维护少量 PE 地址/Locator 路由,无需保存海量 VPN 路由),极具扩展性,能完美配合端到端 SRv6 TE 路径编排。
  • 缺点:跨域的 PE 节点之间需要相互打通底层 Loopback 路由,网络边界控制相对复杂。

端到端 PE 间 MP-eBGP

DCI 差分服务与流量工程(TE)

DCI 跨域模式构筑了跨域路由控制面与数据面拼接的骨架,而 DCI 差分服务与流量工程如熵注入、SRv6 TE Policy 与故障自愈,则是运行在这个骨架之上的高性能流量调度机制。

  • 熵注入(Entropy Injection)与线速多路径负载均衡:在数据包中注入哈希因子(如 IPv6 报头中的 Flow Label 字段),防止深层封装(如 SRv6/VXLAN)导致中间网络设备(P 节点)无法识别五元组,从而引发 ECMP/UCMP 负载均衡极化。
  • SLA 驱动的 SRv6 TE Policy 与路径编排:基于延迟(Delay)、丢包率、带宽等 SLA 指标,通过 Segment List 动态约束数据包的转发路径。
  • 跨域高可用(HA)与故障自愈:网络链路或节点发生故障时,利用预计算的保护路径(如 TI-LFA 50ms 局部收敛)或控制器驱动的全局重路由实现快速自愈。

不同的跨域机制对上述高级流量调度能力特性的支持情况有所区别:

Option A 适合安全/业务隔离要求极高、不同 AS 运维主体独立的 DCI 架构,但它限制了 SRv6 TE 的端到端调度与线速负载均衡能力。

Option B 兼顾了安全隔离与路径编排,是大多数多租户/跨国企业 DCI 网络部署 SRv6 TE 的折中首选。

Option C + SRv6 TE Policy 是超大规模云计算中心/自营 DCI 的终极演进方向。它打破了跨域边界,使熵注入、SLA 路径编排与端到端故障自愈能够发挥最大效能,实现真正的端到端软定义流量调度。

AsterNOS 跨域模式架构选型决策指南

星融元AsterNOS 操作系统已实现了上述 Option A、Option B、Option C 全场景 SRv6 DCI 跨域架构的完整支持,帮助企业与运营商打造具备高弹性、强隔离与极致性能的纯 IPv6 单栈云网融合基础设施。

优先选择 Option C

Option C 是 SRv6 跨域的终极演进形态。ASBR 彻底成为纯三层 IPv6 转发器,控制面与数据面开销降至最低,适合 新建全栈纯 IPv6 云数据中心、AI 智算集群与极致时延场景

  • AI / 大模型算力前端网络:要求纳秒/微秒级确定性互联时延,消除 DCI 网关的解封装或改写抖动。
  • 统一管控运维体系:跨域网络属于同一组织或高度可信实体,能够接受全网 PE Locator 互通。
  • 敏捷云原生流量调度:依赖端到端 SFC(服务功能链)与原生网络切片打通多中心资源的场景。

优先选择 Option B

Option B 在性能与隔离性之间实现最佳平衡,既避免了 Option A 维护海量 VRF 的资源爆炸,又规避了 Option C 必须打通底层 Locator 的拓扑泄露风险,适用于跨运营商互联(Inter-AS)、大规模公有云与中立多租户骨干网

  • 跨不同运营主体:多数据中心属于不同运营团队或租用第三方运营商骨干,出于网络安全合规严禁暴露内部 PE 拓扑。
  • 大规模多租户交付:租户规模达数千以上,边界网关无法为每个租户单独划分子接口与分配独立 VRF 资源。

优先选择 Option A

异构网络改造过渡期、存量小规模互联与强合规专线

Option A 实现逻辑最为直观,双域在控制面与数据面完全物理解耦,对对端网络架构没有强制性的统一约束。

  • 跨厂商/老旧架构渐进式迁移:一侧已升级为 AsterNOS SRv6,另一侧仍为传统三层或异构网络,需在网关处彻底降级为原生 IP 单播交付。
  • 金融/政企合规强隔离:审计要求敏感业务在自治域边界必须终结隧道并还原明文报文,执行精细化接口级安全域过滤。
  • 租户规模可控:跨域互通的 VPN 业务实例通常在几十至几百个以内,ASBR 设备的表项资源无溢出风险。

【参考文档】


产品型号:数据中心交换机
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,数据中心,分布式存储
最后更新:2026-05-26


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

智算网络上 800G 总踩坑?懂了这个“通用语言”,让光模块不再难搞

读懂CMIS状态机,800G光模块管理不再踩坑

封面图

在现代智算中心,网络带宽正从 400G 向 800G 乃至 1.6T 演进。这种快速增长带来了不同厂商、不同速度规格的光模块之间复杂的兼容性问题。

传统的 SFF 接口规范已无法满足复杂的800G网络的需求。作为新一代的光接口管理标准,CMIS正在逐渐成为高性能通算及智算中心场景中的光模块与交换机交互的通用语言。

本文探讨了 CMIS 的基本原理,并分享了在星融元数据中心交换机(AsterNOS)上使用 CMIS 管理光模块的实践经验。

什么是 CMIS?

CMIS(Common Management Interface Specification)协议是一种用于管理和监控光模块的通信协议。

早期光模块的开发依赖于SFF(Small Form Factor)标准系列,主要有以下历史标准:

  • SFF-8472:作为SFP/SFP+时代的标准,它支持数字诊断监控(DDM)。它使用I2C接口来获取电压、温度和光功率数据。
  • SFF-8636:随着向 4 通道架构(例如 QSFP+/QSFP28)的转变,该标准成为多通道模块的核心管理逻辑。

这些传统标准主要定义了 I2C 寄存器访问,但缺乏互操作性。随着网络速度向 800G 迈进,通道配置也变得日益复杂。

CMIS 的诞生提供了统一的管理协议,定义了光模块与系统管理软件之间的接口和数据格式,其中包括主机和模块如何交换信息,涵盖模块识别、状态监控、告警、功耗、温度和 DSP 配置等,并使得系统管理软件可以通过标准接口实现对光模块的配置、监控和管理。

CMIS 确保不同厂商的模块在管理层面上能够互操作,从而无需使用厂商特定的专有方案。

下表对比了传统 SFF 管理接口与现代 CMIS 标准:

标准对比 SFF-8472 / SFF-8636 CMIS
侧重点 SFP/QSFP 的基本监测 800G+ 全面管理和深度检测
运行方式 即插即用 CMIS状态机握手
检测深度 有限;简单的 I2C 命令 高级功能;支持眼图和pre-FEC分析
灵活性 速率特定 基于状态机的动态多速率支持
适用场景 企业网络,低速 高性能AIDC,大规模GPU集群
可扩展性 碎片化;1.6T+支持 统一架构;面向未来的支持

CMIS 并非单一的规范,而是一套基于由光互联论坛(OIF)管理的模块化框架。当前 CMIS base(v5.3)作为其核心基础,规定了通用管理接口、核心管理功能和标准内存映射, 同时也在迭代出一系列补充/分支协议来支持面向未来的升级,例如相干光模块(ZR/ZR+)和 共封装光学(CPO)等。

从“即插即用”转变为“按需配置

在25G或100G时代,光模块的通道数较少,工作模式固定,因此可以实现简单的即插即用。

然而,在800G时代,单通道速率(25G/50G/100G/200G)和通道配置差异显著。在某些场景下,光模块需要通过 CMIS 协议与交换机进行复杂的握手和动态配置才能正常运行。

基于状态机的握手

根据 CMIS Base v5.3,光模块和交换机之间的交互由严格的状态机控制,其功能类似于精确的开机自检:

  • 初始化:上电后,交换机通过标准 I2C 接口读取模块的身份并验证其基本功能。
  • 就绪:模块初始化完成后,进入就绪状态。此时,交换机可以检索详细参数,例如电压、温度和光功率,并发出业务配置命令。
  • 操作状态:模块仅在配置参数与物理链路匹配并经状态机确认后才进入操作状态。数据传输由此开始。

如果链路建立失败,交换机可以读取状态机代码,以确定模块是在“初始化”过程中停滞,还是由于“配置不匹配”而停滞。这为故障排除过程中的根本原因分析奠定了基础。

动态配置

CMIS Base v5.3 引入了使用应用程序代码的动态配置,从根本上改变了模块的管理方式:

  • 从静态预设到按需重配置:以前,模块的速率模式在出厂时就已经固定。现在,借助 CMIS,交换机可以实时地向模块推送不同的应用代码。
  • 基于场景的自适应:无论是将 800G 端口拆分为 4x200G 端口,还是切换调制格式(例如 PAM4),交换机只需指示模块“切换到模式[x]”。模块的内部 DSP 和电气接口会自动执行必要的参数调整。
  • 统一控制标准:无需手动操作复杂的寄存器地址。通过标准的CMIS接口,它确保了不同厂商的模块在高速网络环境下的互操作性和稳定性。

简而言之,由于网络业务的复杂化,光模块也从“即插即用”转变为“按需配置”;而借助 CMIS 接口,交换机可以指示光模块自动切换到所需模式以支持特定的业务需求。

800G AIDC 网络实践

CMIS 在生产中的核心价值体现在两个方面:提供光模块实时性能遥测数据(温度、电压、光功率和偏置电流),以及通过智能化运维管理解决高性能 AIDC 网络中遇到的链路问题,为AI集群提供更稳定的网络环境。例如:CMIS 可提供精细的信号质量指标(如 Pre-FEC的误码率),在光模块触发完全链路中断事件之前被检测到,有效地防止 AI 工作负载中出现计划外停机。

搭载 AsterNOS 的星融元数据中心交换机已集成 CMIS 协议,同时可通过 AIDC 运维平台提供可视化的管理界面,以下是近期我们基于 CMIS 在真实的 800G AIDC 网络交付中处理的两个现场案例。

产品

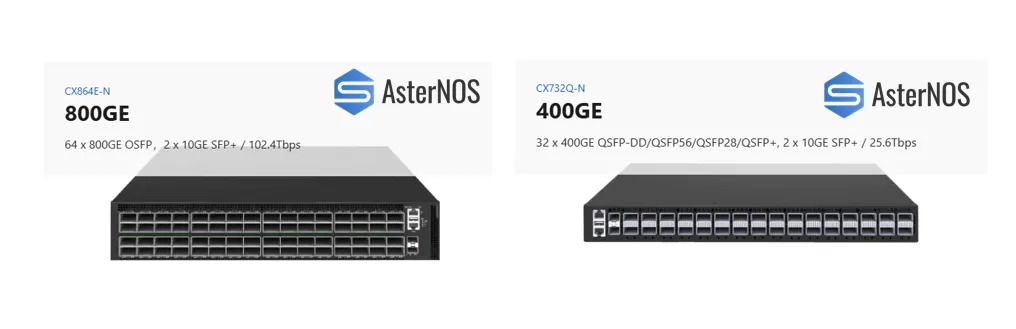
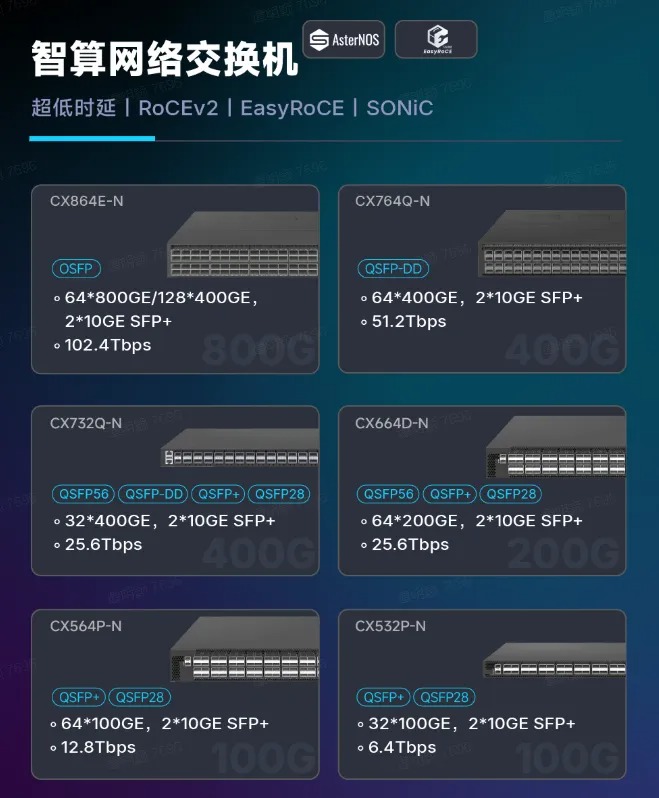
品牌 型号 端口规格 操作系统
星融元Asterfusion CX864E-N 64 x 800GE OSFP,2 x 10GE SFP+ AsterNOS-Datacenter(企业级SONiC发行版)
星融元Asterfusion CX732Q-N 32 x 400GE QSFP-DD/QSFP56/QSFP28/QSFP+, 2 x 10GE SFP+ 同上

Breakout 子接口的掉线

网络配置情况

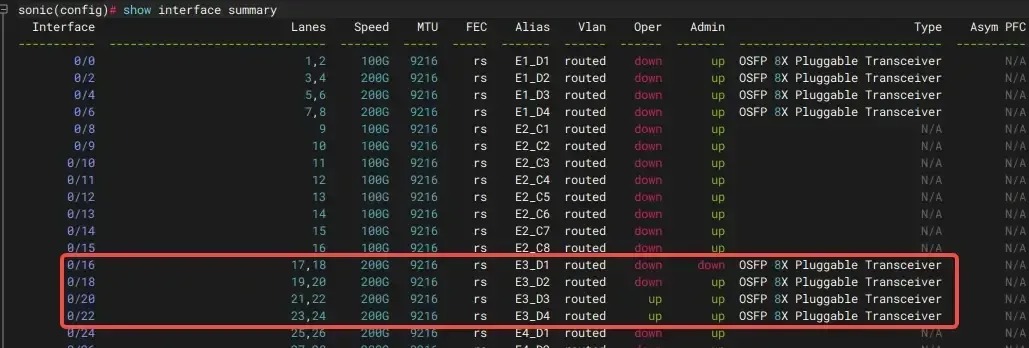
本地为 CX864E-N 交换机,初始配置为 ethernet 0/16 4x200G breakout,链路正常运行。 对端为 CX732Q-N 交换机,配备两个 400G DR4 模块,并配置为 2x200G breakout。

问题

在 800G DR8 模块上执行 4x200G 的 breakout 时,当关闭其中一个子接口会触发其他子接口链路断开。具体来说,在 ethernet 0/16 接口上下发 shutdown 命令会导致接口 0/18、0/20 和 0/22 也同步断开。

配置情况截图

原因分析

由于未启用 CMIS,800G-DR8 模块默认使用应用代码 2(400G BASE-DR4 模式)。模块配置的速度与接口的实际数据速率不匹配,导致子接口之间相互干扰

解决路径

启用CMIS,系统自动识别端口要求并选择应用代码3(200G BASE-DR2模式)。由于电气接口速度匹配正确,链路立即稳定下来。

经过此项更改后,由于该模块现在锁定到正确的 200G BASE-DR2 模式,因此四个子接口在模块可在数据路径级别上独立运行,关闭 ethernet 0/16 不再影响接口0/18、0/20和0/22。

800G DR 模块在 8x100G Breakout 模式下不工作

问题

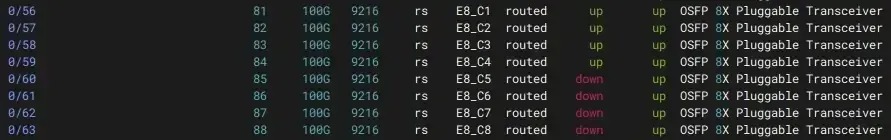
交换机插入 800G 模块后,状态指示灯不亮,所有相关接口均保持关闭状态。

配置截图

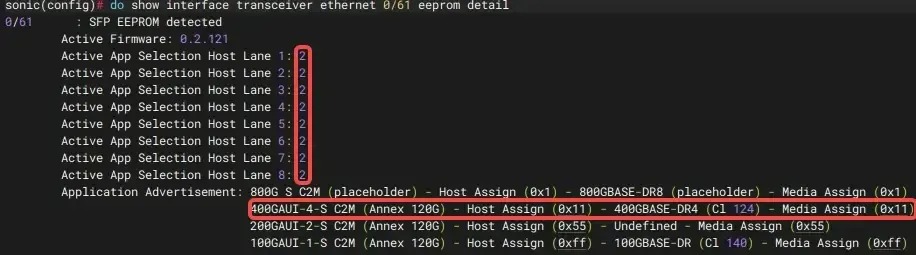
原因分析

该模块默认使用了错误的“应用代码2”模式(400G 通道速率),未能识别所需的 100G 通道速率配置。

配置截图

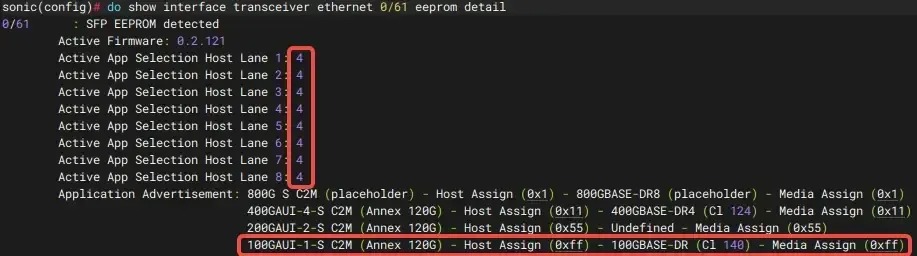
解决路径

启用CMIS后,该协议会根据端口配置自动将速率模式调整为应用代码“4”(100G 模式)。参数同步后,链路得以正常建立。

配置截图

相关阅读


产品型号: 星融元(Asterfusion)CX864E-N (64 x 800G OSFP)
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,分布式存储
最后更新:2026-05-18


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

基于意图的一键编排:大规模 AIDC 网络业务的极速开通实践

从逐设备手工配置到分钟级一键交付 —— 星融元 AIDC 运维管理平台实践

AIDC运维-文章封面

在AI数据中心场景下,网络规模大、设备数量多,传统依赖逐台设备手工配置的部署方式难以满足快速交付与一致性要求。

基于意图的一键编排

AIDC 运维平台

星融元 AIDC 运维管理平台是专为 AI 智算中心打造的网络管理产品,通过 自动化部署与模板化编排 能力,将传统“逐设备配置”的部署模式转变为“基于意图的一键编排”,以提升AI数据中心网络的交付效率。

  • 设备自动上线与集中纳管(ZTP)
  • 基于场景模板的拓扑自动生成
  • 规划拓扑与真实拓扑的自动校验
  • 分阶段配置下发与业务快速开通

快速配置流程

第一步:设备自动上线和入库

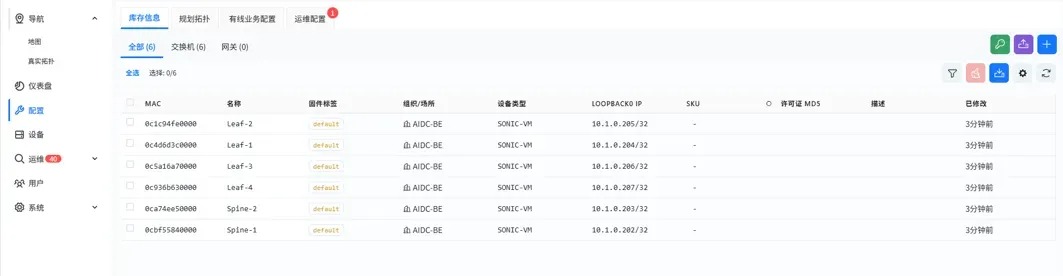
设备完成基础上架并配置网络运维平台 IP 地址后,将自动通过 WebSocket 与平台建立连接。连接建立后,设备将被自动纳入平台统一管理,并进入默认资源池(组织)。

管理员可根据实际部署需求,将设备批量划分至指定场所或业务域,用于后续拓扑规划与业务部署。

AIDC运维平台

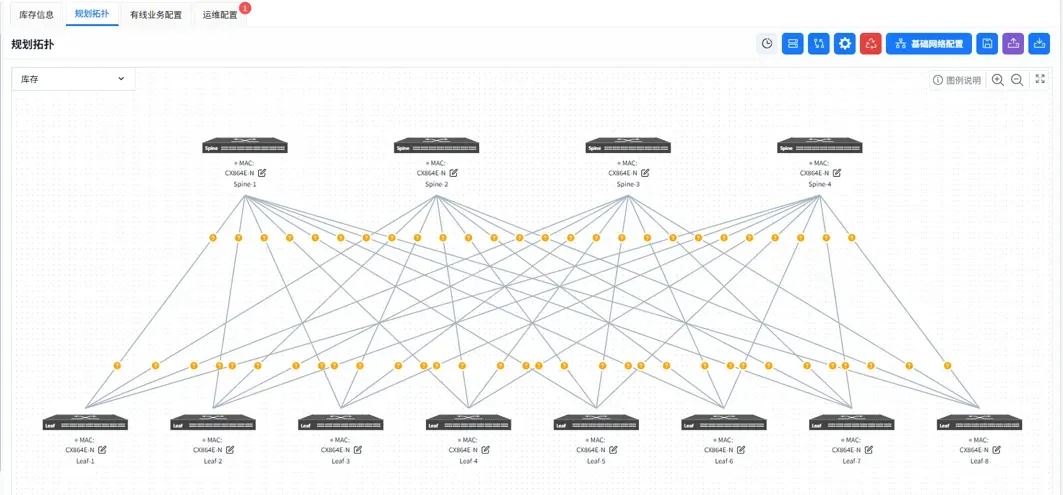
第二步:场景拓扑自动化生成和校验

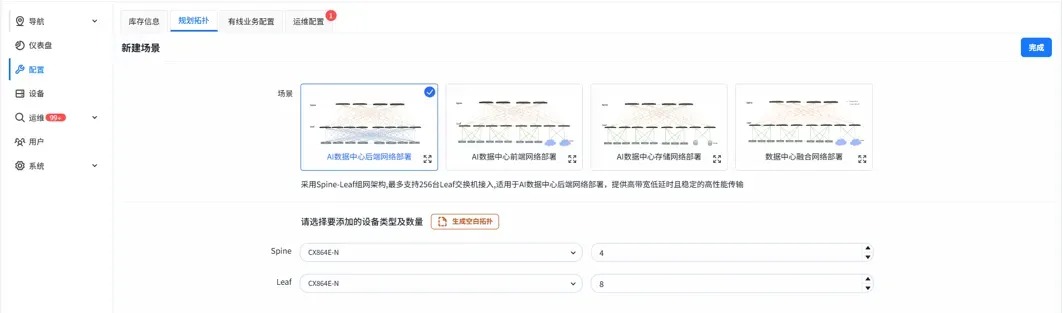
选择模板:根据场景一键生成所需组网拓扑

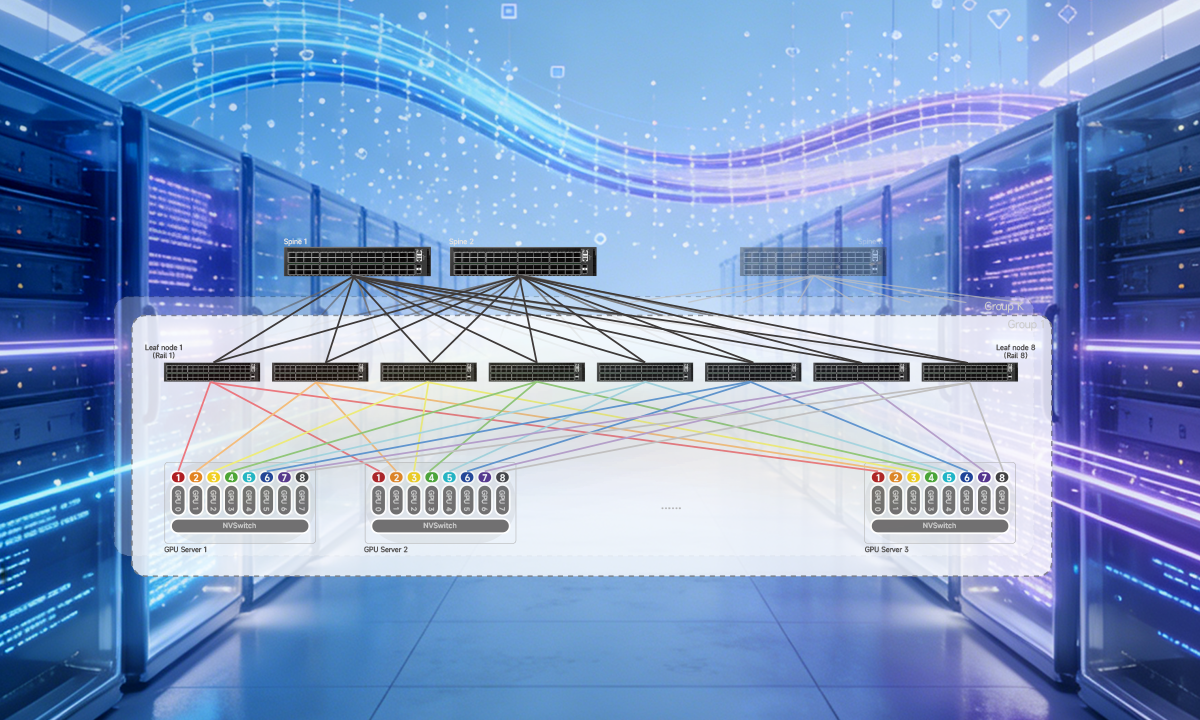
一个标准的 AI 智算中心架构主要分为计算后端网、前端网(业务应用网)、存储网和带外管理网。

网络分类 流量方向 核心追求 常见应用场景
AI 后端网 东西向(卡对卡) 超低时延、零丢包、高带宽 大模型分布式并行训练、梯度同步
AI 前端网 南北向(内外交互) 高可用、通用性、灵活性 任务提交、API 调用、推理服务响应
存储网 东西/南北结合 高吞吐量、并发读写 训练数据集加载、模型 Checkpoint 读写
带外管理网 运维控制 极高可靠性、物理隔离 远程开关机、BMC 监控、固件升级

面向智算中心不同网络的需求(也兼顾传统数据中心网络),该平台目前支持以下几种常见的场景配置模板。

AIDC运维平台

  • AIDC 后端网络(AI 训练网)

AIDC 后端网络连接到 GPU 服务器集群,负责 GPU/NPU 节点之间东西向高吞吐和超低时延通信(参数和梯度交换)。在大模型并行训练(如数据并行、流水线并行、张量并行)中,全归约(All-Reduce)等集合通信算法极度依赖 AI 后端网的性能。

该标准模板采用 Spine-Leaf 架构,支持大规模节点接入,包含交换机 RoCE、智能选路及 ARS(自适应路由切换)等配置能力,以满足高带宽、低时延及无损传输需求。

  • AIDC 前端网络(业务管理网络)

AIDC 前端网负责南北向业务流量和常规的管理调度通信,包含训练任务的提交、集群 API 交互、推理服务接入以及互联网/企业内网的访问。

该标准模板基于交换机 EVPN MC-LAG 技术实现链路冗余与业务隔离,保障业务接入的高可靠性。

  • AIDC 存储网络(存储后端网络)

AIDC 存储网络是连接 GPU 计算节点与高性能分布式存储(如并行文件系统/对象存储)的专网,要求同时具备高并发读取带宽和极高写入吞吐量。

该标准模板支持配置分布式网关、MC-LAG 及 RoCE 技术,提升存储访问性能与可靠性。

  • 数据中心融合网络

支持基于 EVPN MC-LAG 或 EVPN Multihoming 的典型组网方式,适用于传统数据中心业务场景。

自动校验拓扑:确认设备实际连接同规划一致

AIDC运维平台

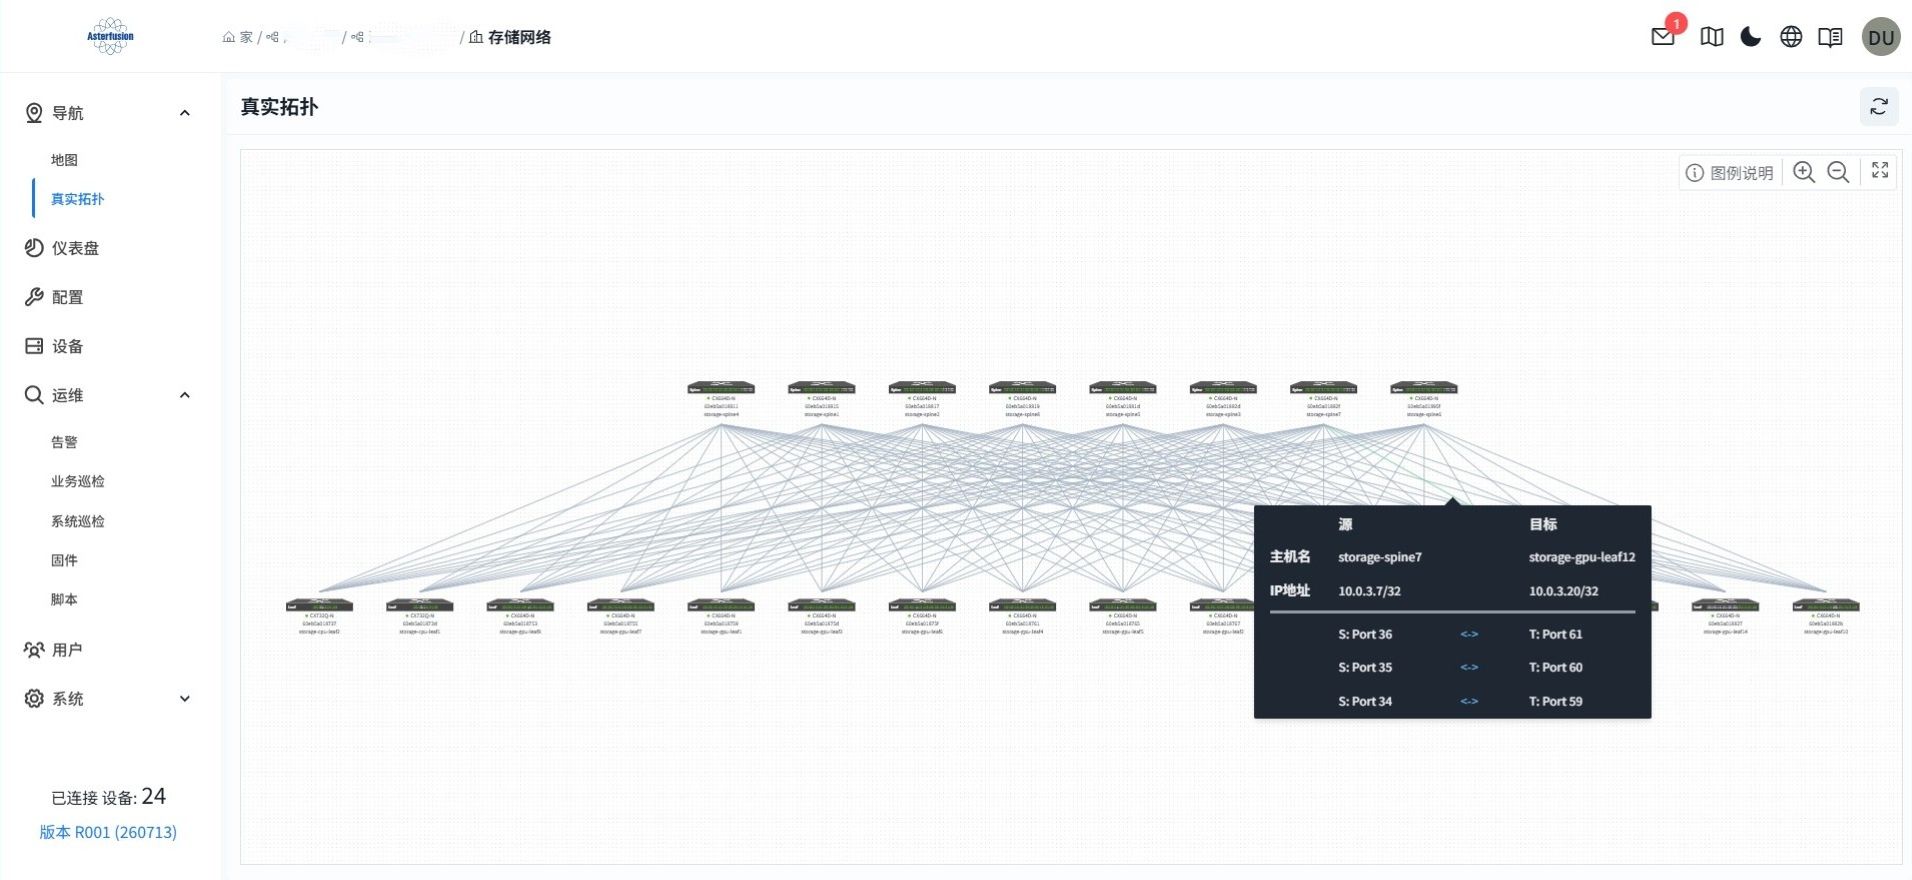
设备上线后,网络运维平台自动发现设备间的链路关系,生成真实网络拓扑,并与规划拓扑进行一致性校验,校验通过后,即可进入配置下发阶段。

第三步:分阶段的业务配置下发

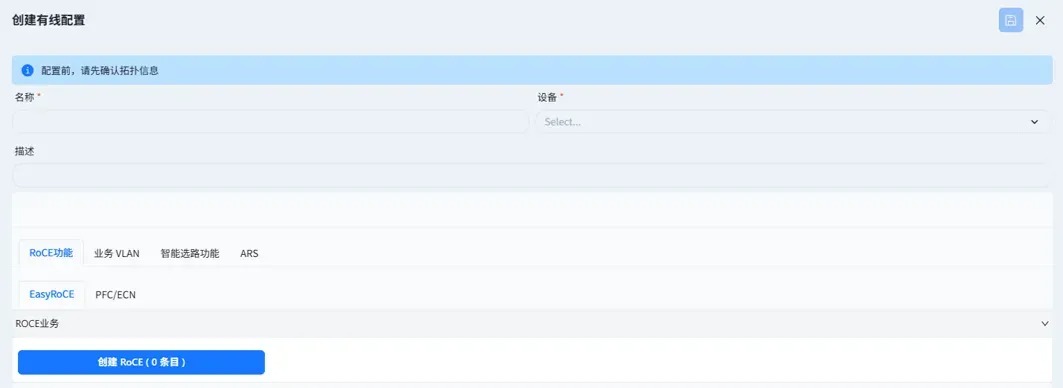
基础网络配置:以AI 后端网为例,该阶段自动建立BGP邻居,用户无需为互联口手动规划IP地址;Spine交换机宣告各 Rail 网段路由,实现全网互通,BGP Peer-group 批量下发,向全网设备推送基础网络配置,等待状态同步完成即可进入业务配置阶段。

运维

业务配置:根据业务需求启用相关功能,例如 VLAN 与网关规划,自适应路由切换(ARS)等

AIDC 运维平台

第四步:RoCE 网络的优化设置

在 AI 数据中心网络中,RoCE 相关参数(如PFC、ECN)的配置对网络性能具有重要影响。不同业务场景下对时延、吞吐及拥塞控制的要求存在差异。

星融元 AIDC 络运维平台采用“模板化配置 + 参数微调”的方式,实现RoCE网络的高效部署与精细化优化:

RoCE 参数配置模板:平台内置多种面向典型AI业务场景的 RoCE 参数模板,预定义 PFC 优先级、ECN 标记策略等关键参数组合。用户可根据业务类型选择合适模板,快速完成网络基础配置,降低参数配置复杂度。

AIDC运维-RoCE参数配置模版

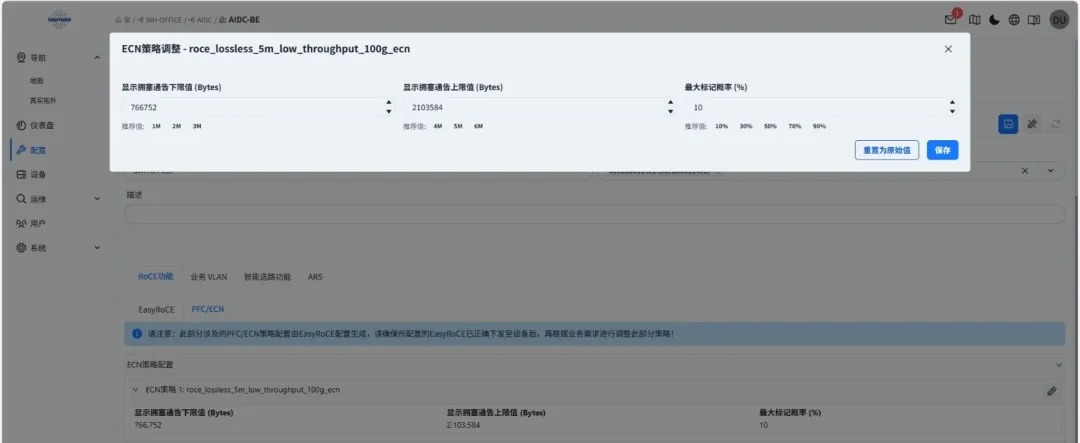
RoCE 参数微调:如下图所示,在模板基础上,平台支持对 PFC、ECN 等关键参数进行灵活调整,例如 ECN 标记阈值、队列水线等,以适配具体业务负载特征,实现性能的进一步优化。

AIDC运维-RoCE参数微调

涉及交换机设备

AIDC 网络运维平台目前支持管理 CX-N系列交换机,产品基础规格参数如下。

https://asterfusion.com/product/cx-n/


产品型号: 星融元(Asterfusion)ET3600系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……

应用场景:企业路由器,路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


产品型号: 星融元(Asterfusion)ET2500系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……

应用场景:路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

解读 AsterNOS 热重启技术:控制面动态重构与数据面持续转发

解耦控制与转发,保障关键业务永续在线

warm reboot

在现代云数据中心网络及AI智算中心网络中,高可用性和业务连续性是衡量网络基础设施能力的核心指标。

传统的设备冷重启(Cold Reboot)方式在进行软件重载时,会导致交换机的控制平面与数据转发平面同时中断,这往往会引发协议邻居断开、路由重新收敛等一系列连锁影响,进而造成数分钟的流量中断,会对网络连续性要求较高的业务产生较大影响。

由此,热重启(Warm Reboot)技术应运而生。

什么是热重启?

区别于冷重启,热重启的目标是在尽量不影响数据平面的前提下,重启和升级软件,包括其中的每个独立进程/容器的热重启也属于该目标的范畴。

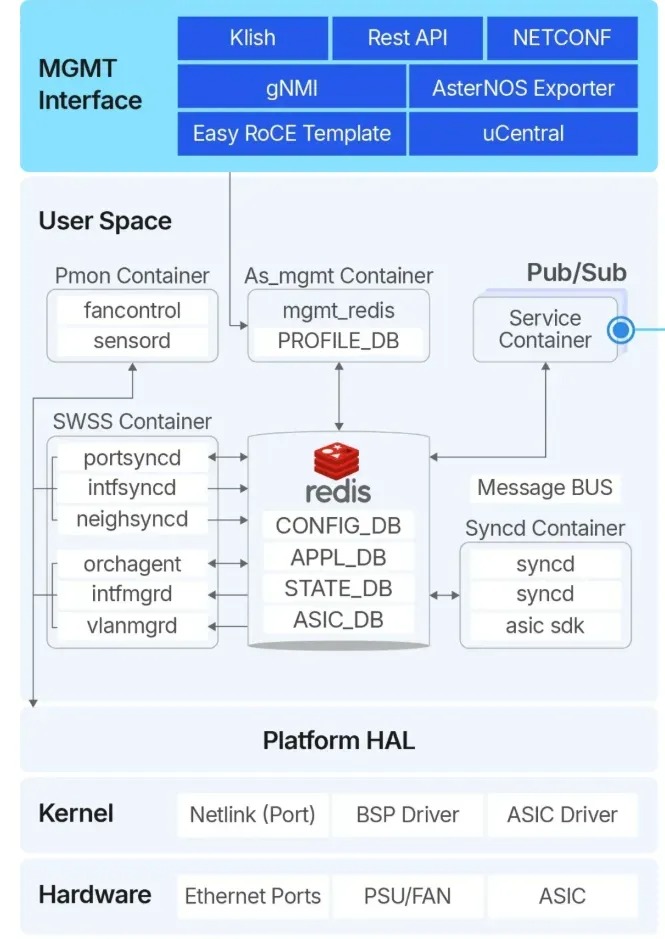
星融元 AsterNOS 对热重启的支持得益于 SONiC 架构所提供的控制平面与数据平面解耦、模块化和容器化设计。

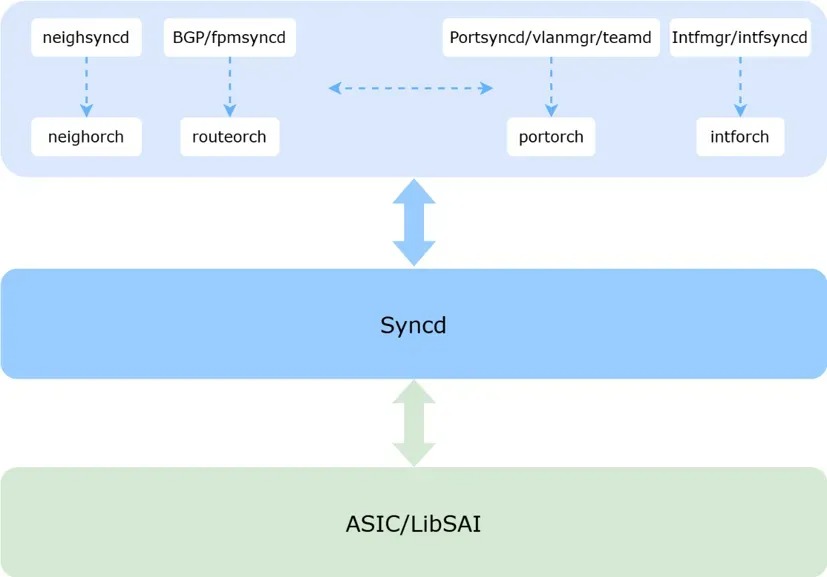
与传统封闭式网络操作系统中架构不同,AsterNOS 软件进程与底层硬件状态并非高度耦合,而是将核心网络功能和系统服务以容器化、模块化方式运行,并通过 Redis 数据库对系统配置及各模块间的运行状态进行统一管理和交互。这为系统状态的持久化和快速恢复提供了基础。

AsterNOS 软件架构

热重启基本工作原理

AsterNOS 实现热重启的核心机制是:在交换机控制面软件重启过程中,持久化保存关键系统配置及运行状态,同时保持底层ASIC中已有的转发状态,使数据平面能够继续利用原有的硬件转发表项进行数据转发。

当控制面软件完成重启并恢复运行后,通过状态同步机制恢复对数据平面的正常管理,从而实现控制面快速恢复与业务连续性的兼顾。

AsterNOS 热重启机制架构图

网络应用程序与Orchagent:Orchagent是SONiC交换机状态服务 (SwSS) 容器内部的中央编排和转换引擎,每个应用程序及其对应的Orchagent子模块需要协同工作,以恢复原始数据并生成用热启动的增量数据。

Syncd:在重启之前,Syncd将ASIC_DB的数据转储出去。当 Syncd 容器热启动重新拉起后,将读取转储数据,从而在内存中重构出重启前的软件内部状态。Syncd 会接收来自 Orchagent 的变更数据,并在进行必要的转换后将其传递给 LibSAI/ASIC。

LibSAI/ASIC:ASIC芯片在软件重载期间须保持原有的硬件转发表项持续运行,确保数据平面的转发流量不中断。LibSAI 通过读取重启前保留的序列化文件,接管当前正在工作状态的 ASIC 芯片。

AsterNOS 的视图协调和匹配算法

为了让热重启后重构的“控制面状态”与未曾中断的“底层硬件状态”完美对接,星融元 AsterNOS 网络操作系统采用视图协调机制与匹配算法,避免对硬件进行破坏性的全量覆写,其主要步骤如下:

构建双视图

  • 当前视图(Current View):重启前已经下发到 ASIC,且在重启期间硬件正在使用的真实状态;
  • 临时视图(Temporary View):代表本次控制面热重启后,根据数据库重新计算并期望下发的目标状态。

快速匹配

  • 算法优先提取那些在热重启期间不会发生改变的“交换机内部固定对象”(不变量,如物理端口、硬件队列、调度器等)作为锚点;
  • 对比临时视图和当前视图中这类对象的 VID,如果 VID相同,它们对应的物理 RID 也必定一致,算法直接将其标为 MATCHED 状态,免除后续深度遍历,极大地降低算法开销。

深度过渡比对

  • 算法以不变量为锚点,对于临时视图中的每个对象,向下递归比对。
  • 对每个临时对象,在当前视图中查找一个最适合复用的对象。若未找到匹配项,则向硬件下发新增指令;若找到最佳匹配但其包含的属性不同,则下发差异更新指令;若找到精确匹配且属性一致,则直接复用,不产生任何底层写入。

陈旧表项清理

比对完成后,扫描当前视图中所有未被标记为MATCHED 且引用计数归零的对象,将其从硬件中安全移除。通过一致性绝对优先策略,确保控制面与数据平面状态达到一致。

典型应用场景

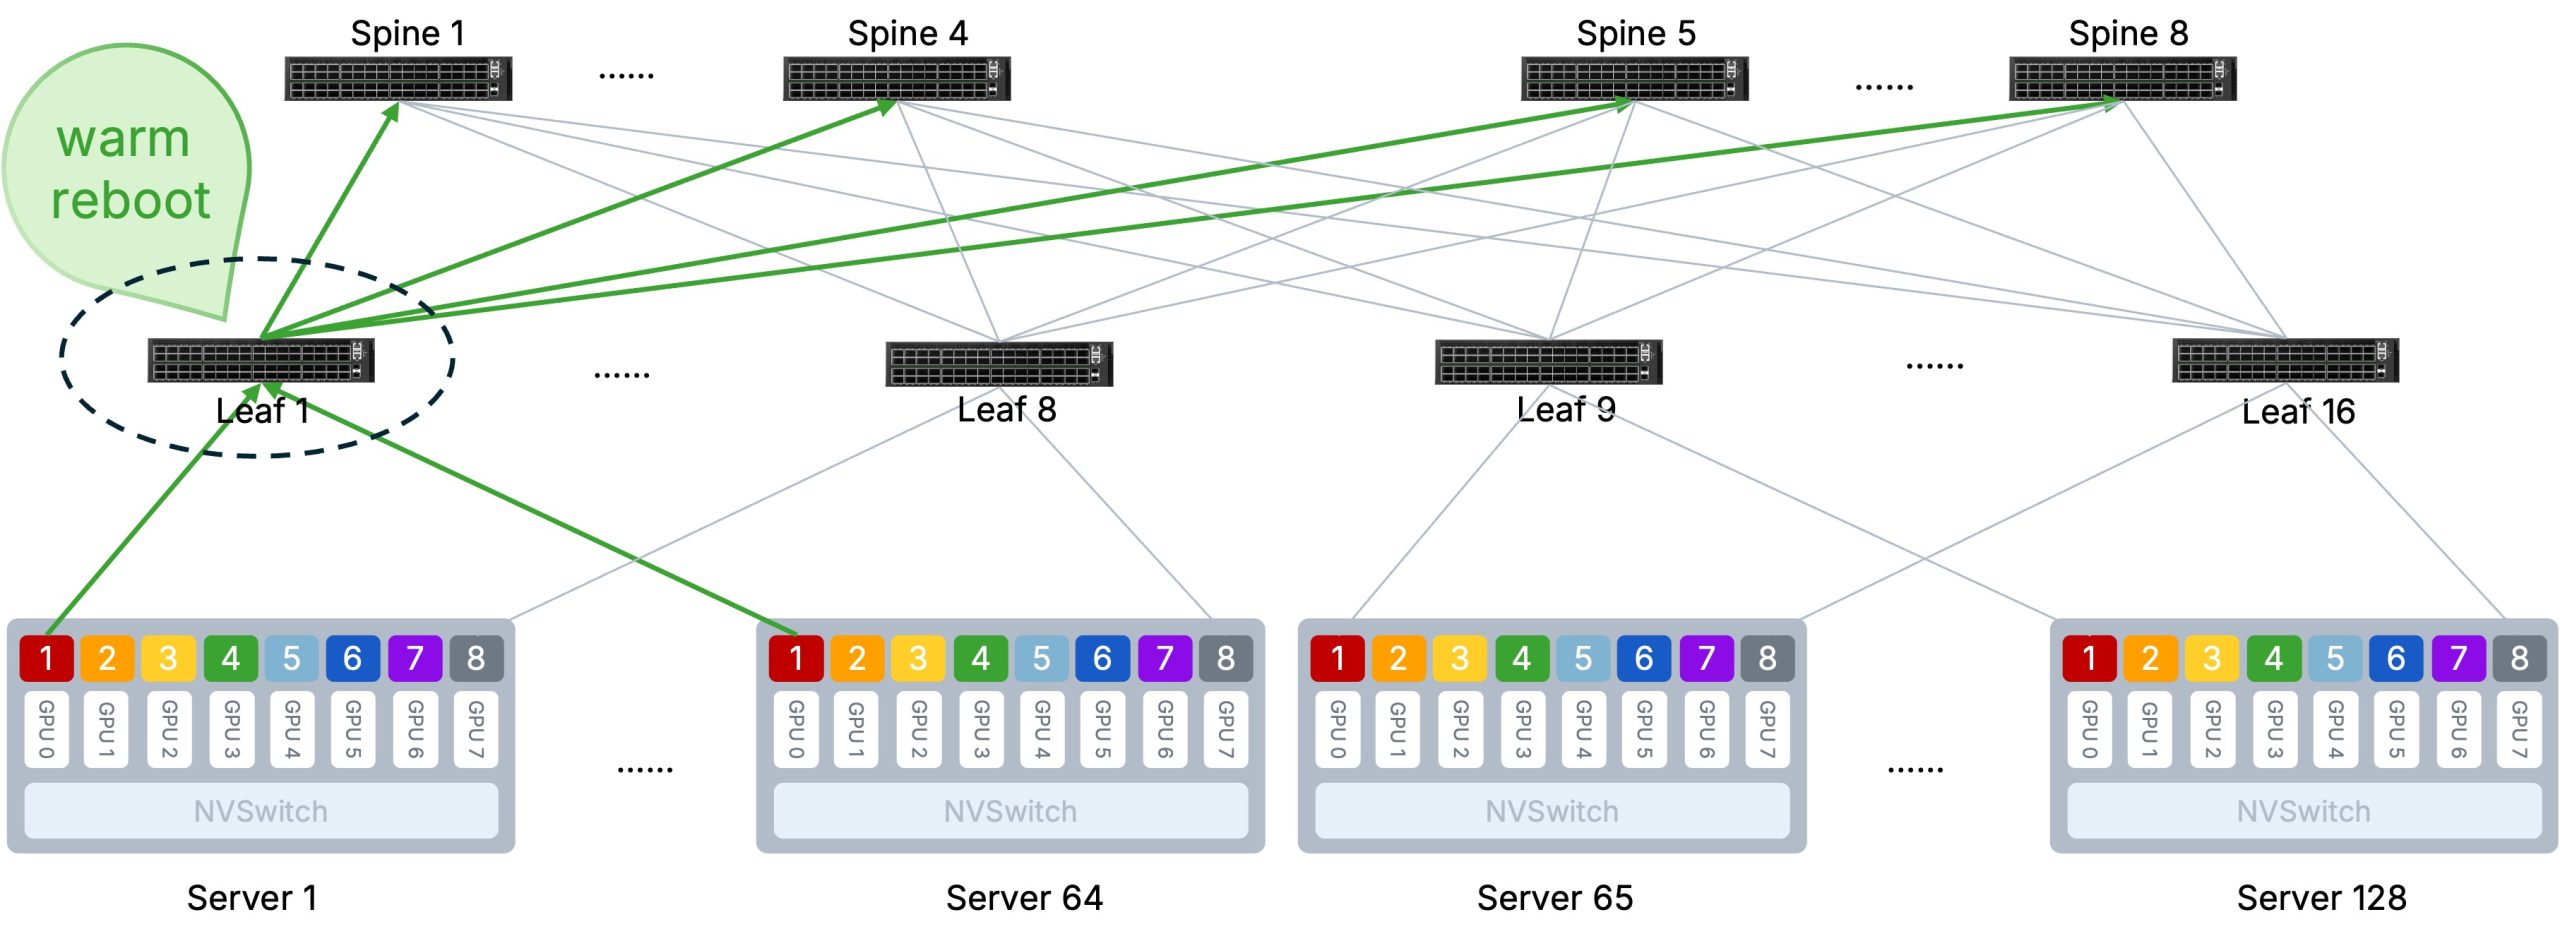
AI智算中心:保障大规模训练业务连续性

在构建千卡及万卡级别的 AI 分布式训练集群时,大模型训练周期通常长达数周甚至数月。在此期间,交换机系统的软件版本升级和漏洞修复是不可规避的运维行为。

如采用传统的整机冷重启,会导致集群内大范围的网络中断,直接打断正在运行的分布式计算任务,导致 GPU 算力闲置与资源浪费。

借助星融元 AsterNOS 的热重启技术,运维人员可以对交换机操作系统执行无缝的热升级。在系统热重启过程中,底层交换芯片保持转发,从而实现数据中心网络的热平滑维护,提升了算力集群的整体可用性。

AI智算中心热重启示意图

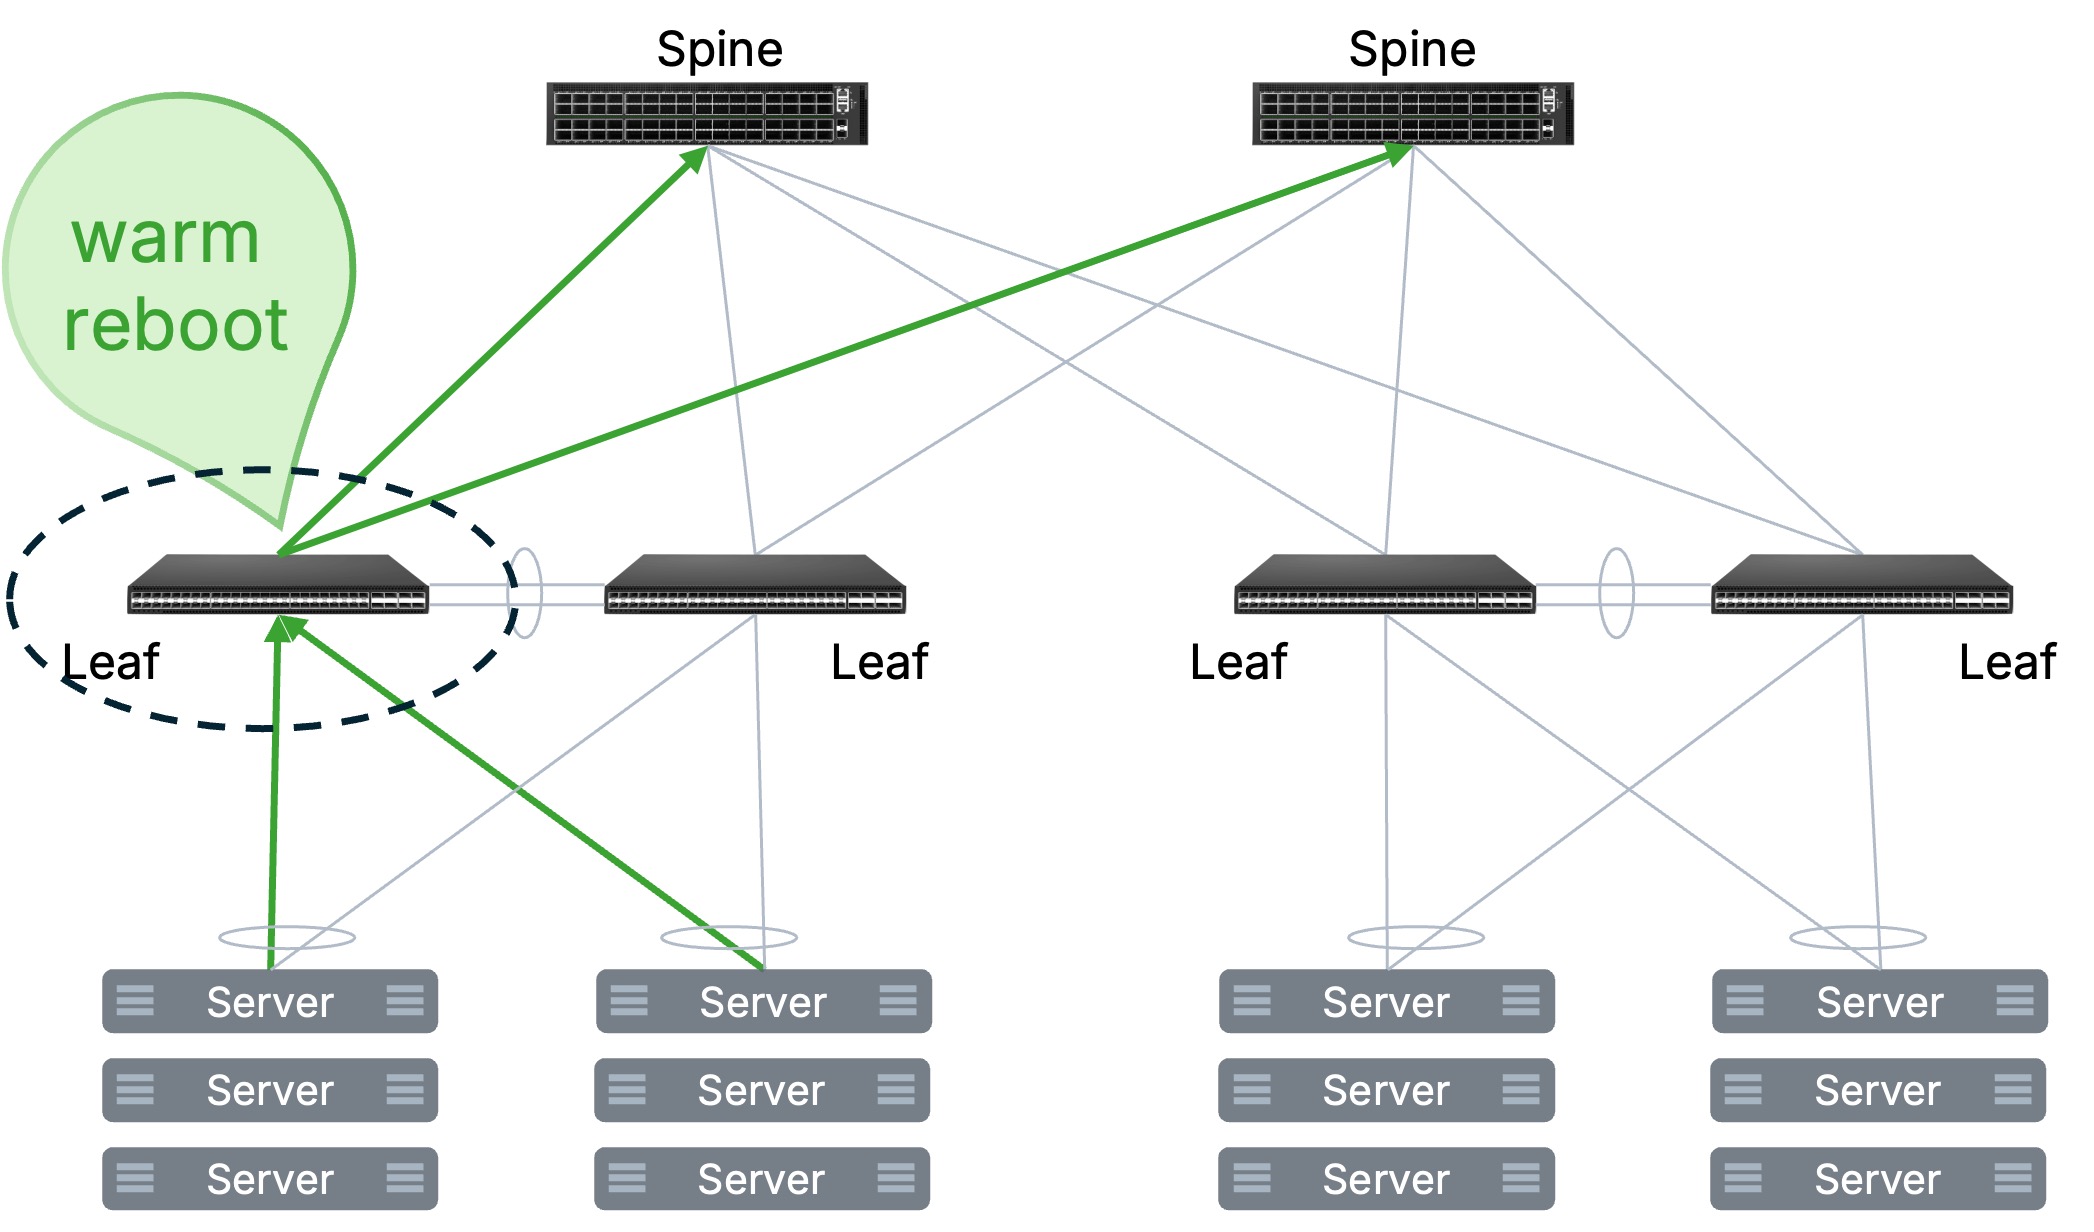
云数据中心:实现关键业务平滑升级

在多租户的公有云和私有云数据中心中,网络承载着大量对丢包和时延高度敏感的关键业务,如在线金融交易、实时音视频、云存储数据同步等。

传统的交换机升级往往需要复杂的流量引避流程,若直接执行冷重启,会导致 Spine 或 Leaf节点出现长达数分钟的流量黑洞与业务中断。

借助热重启技术,网络运维团队能够在真实业务流量持续运转的“带流”状态下,对现网交换机执行平滑的在线软件升级。在控制面操作系统重载、路由协议(如BGP等)执行平滑重启与状态重建的过程中,底层硬件 ASIC 芯片基于重启前锁定并固化的转发表项,持续提供线速数据转发。

这种机制确保了云数据中心在进行网络版本迭代、新特性发布或紧急安全打补丁时,实现业务层面的“无感升级”与数据面平滑切换,使底层网络基础设施的演进对云端租户透明。

云数据中心热重启示意图

数据中心交换机


产品型号:数据中心交换机
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,数据中心,分布式存储
最后更新:2026-05-26


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

下一代数据中心网络重构:从 EVPN-VxLAN 走向端到端 SRv6 Fabric

从VxLAN到SRv6:面向AI算力时代的网络底座演进

SRv6

在过去十年的云计算演进中,EVPN-VxLAN 几乎是数据中心虚拟化与多租户网络的标准底座。它打破了传统 VLAN 4096 的隔离上限,在三层物理网络(Underlay)之上构建起无感漂移的虚拟二层网络(Overlay)。

然而,随着大模型分布式训练、高密 GPU 算力集群以及跨数据中心协同计算的爆发,网络流量特征发生了根本性变化。传统 VxLAN 架构在面对海量大象流调度、跨域协议打通以及报文封装开销时,逐渐暴露出结构性短板。基于原生 IPv6 的 SRv6(Segment Routing over IPv6)正迅速从广域网下沉至数据中心内部,有望成为新一代算力 Fabric 的核心底座。

为什么 VxLAN 在 AI 与多云时代难以为继?

在传统通用云场景下,VxLAN 很好地满足了虚拟机和容器的多租户隔离诉求。但当基础设施向异构算力和多中心协同演进时,VxLAN 的局限性越发明显:

VxLAN的局限性

1. 跨域“协议缝合”(Protocol Stitching)与网关瓶颈

在多数据中心(DCI)或混合云互联场景中,数据中心内部通常运行 EVPN-VxLAN,而广域网骨干网多采用 MPLS、SR-MPLS 或纯 IP 路由。

状态开销与单点瓶颈: 出入数据中心的边界网关(Border Leaf / DCI Gateway)必须承担复杂的协议转译与状态维护工作——解封装 VxLAN、剥离内部标签、查询路由并重新封装为 MPLS/WAN 报文。

运维割裂: DC 内部与跨域骨干网使用完全不同的 OAM 监测机制,端到端故障定界与性能遥测极为困难。

2. 算力“大象流”遭遇 ECMP 极化

AI 智算集群(如 LLM 预训练与微调)的通信模式以大跨度集合通信(AllReduce、All-to-All)为主,流量表现为流数少、突发单流吞吐大(大象流)。

  • 哈希碰撞(Hash Collision): 传统数据中心依赖等价多路径路由(ECMP)分发流量。VxLAN 依赖外层 UDP 源端口做哈希分流,少量突发大象流极易被哈希至同一条物理链路,引发局部严重拥塞。
  • PFC 风暴与 MFU 下降: 在 RoCEv2 无损网络中,链路拥塞会频繁触发 PFC(优先级流量控制)反压,严重时导致 PFC 死锁或巨量排队时延,最终拉低整个集群的算力利用率(MFU, Model FLOPs Utilization)。VxLAN 本身缺乏灵活的流量工程(TE)能力,无法根据网络拥塞实时调度路径。

3. 封装开销与芯片流水线解析代价

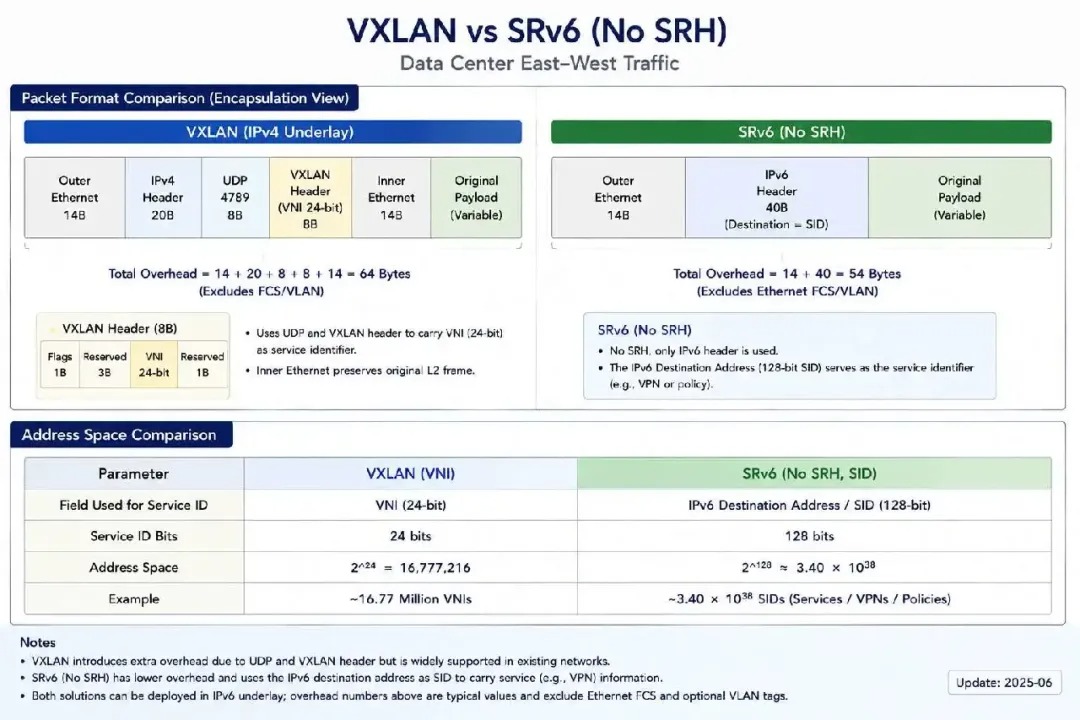
VXLAN vs SRv6

标准 VxLAN 引入了至少 50 字节的额外包头开销(外层 MAC + IPv4 + UDP + VxLAN Header)。在大模型梯度同步与频繁的参数小包交互中,这不仅降低了有效载荷的吞吐利用率,也对交换机 ASIC 的报文解析深度(Parsing Depth)和查表流水线造成额外负担。

新一代 SRv6 Fabric 的技术原理

SRv6

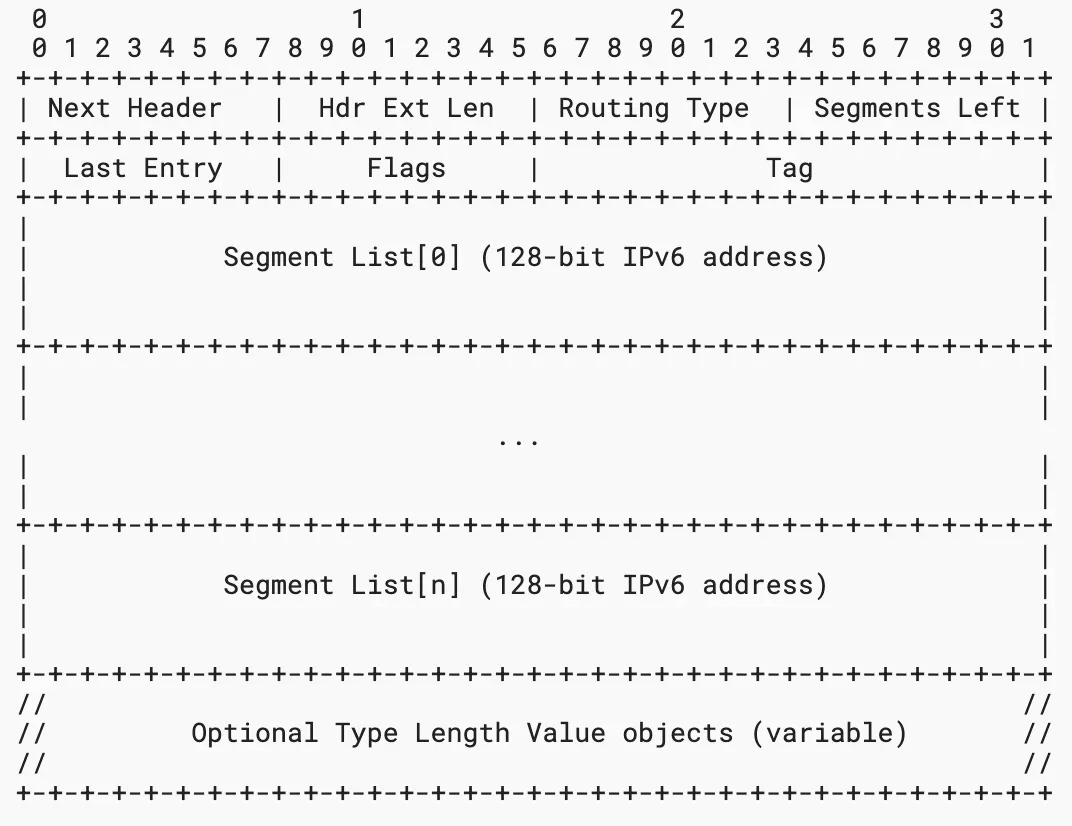
SRv6(Segment Routing over IPv6)并非简单的隧道协议,而是基于“源路由(Source Routing)”理念与原生 IPv6 扩展头构建的网络可编程指令集。

核心维度 EVPN-VxLAN 架构 下一代 SRv6 Fabric 架构
转发平面 IPv4/IPv6 Underlay + UDP 封装 + VxLAN 头部 原生 IPv6 + 路由扩展头(SRH / NEXT-CSID / REPLACE-CSID)
模块扩展性 极差(需要厂商为第三方模块适配源码)。 优秀(原生二进制模块 100% 即插即用)。
控制平面 BGP EVPN(分配 VNI / L2-L3 标签) BGP EVPN(分配 SRv6 SID,如 End.DT4/DT6)
跨域能力 依赖边界网关进行解封与标签重写 全网统一 IPv6 寻址,端到端一跳直达
流量工程 (TE) 依赖 Underlay 独立机制,Overlay 无法干预 SRv6 Policy 显式路径编排,毫秒级源路由避障
报文开销 固定 50 字节封装开销 支持C-SID压缩编码(每跳仅占 16/32-bit)

1. 统一寻址与网络指令化:Locator:Function:Args

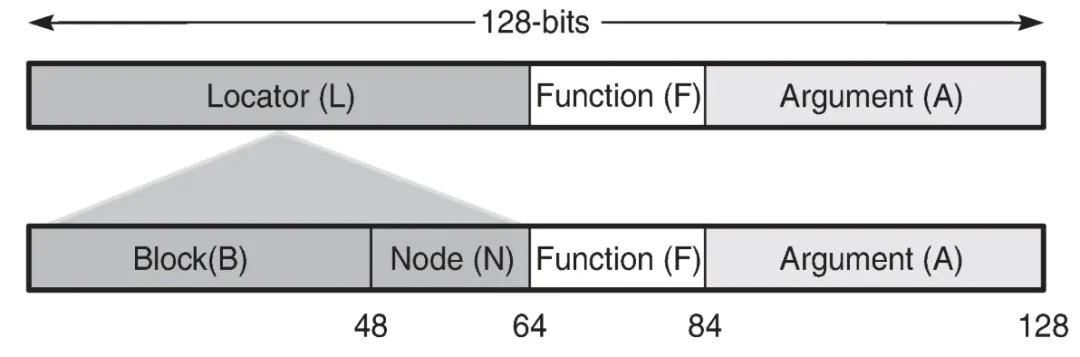
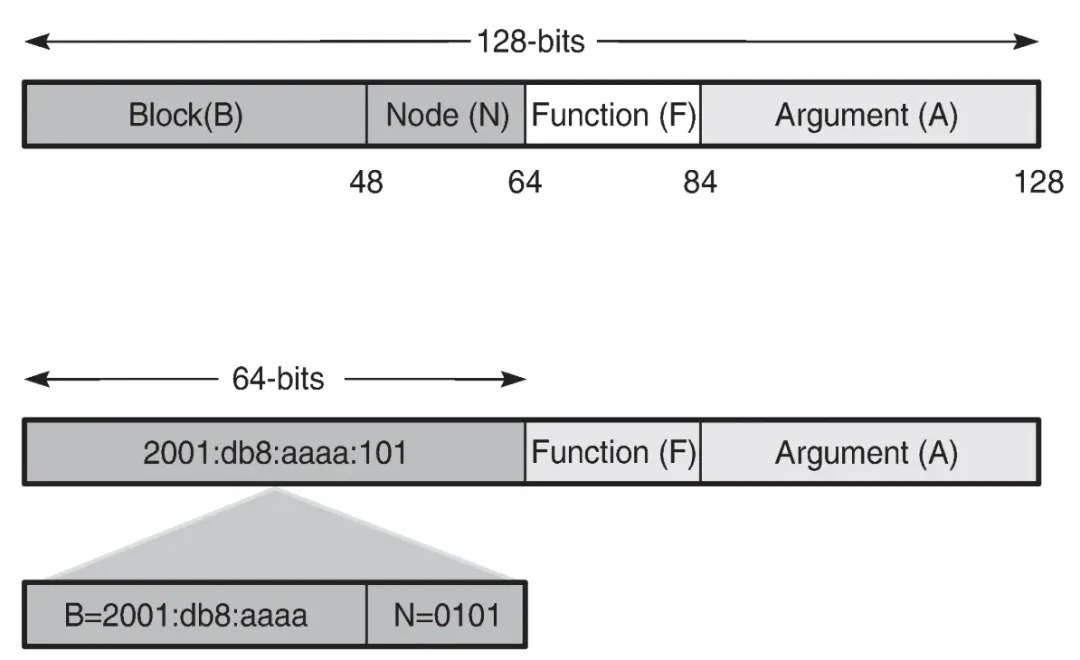
SRv6 将网络节点与业务行为统一抽象为 128 位的 IPv6 地址(Segment ID, 简称 SID),分为三个逻辑段:

 统一寻址与网络指令化

统一寻址与网络指令化

  • Locator(定位符): 负责全网 Underlay 路由可达。普通中间节点只需按照标准 IPv6 路由(如 BGP/OSPFv3)进行最长前缀匹配转发,无需维护复杂的隧道表项。
  • Function(功能指令): 指定目的节点执行的具体网络动作。
  • End.DT4 / End.DT6:解封装并进入指定 VRF 查找 IPv4/IPv6 路由表(实现 L3 多租户隔离)。
  • End.DX2:解封装并将内层二层帧直接转发至指定出接口(实现 L2 EVPN 业务)。
  • Args(参数段): 携带流表匹配、安全标记或网络遥测元数据。

2. EVPN over SRv6:扁平化多租户承载

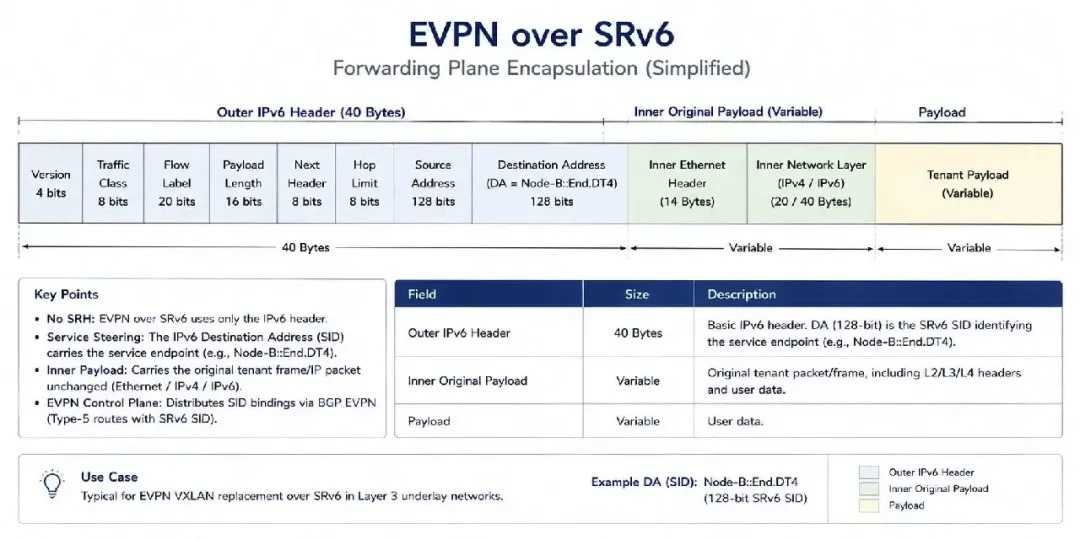
控制平面依然采用成熟的 BGP-EVPN,但实现机制大幅简化:

在路由发布阶段,Egress Leaf 通过 BGP Prefix-SID 属性直接向全网通告业务 SID(例如 2001:db8:1::End.DT4)。

Ingress Leaf 收到租户数据后,直接将对应的 IPv6 SID 作为目的 IP 封装外层报文。报文在 Fabric 内部透明转发,无需在 Spine 节点上维护任何租户隔离状态。

EVPN over SRv6

3. SRv6 Policy 与智能源路由调度

针对 AI 算力集群中 RoCEv2 的大象流调度痛点,SRv6 提供了确定性的流量编排手段:

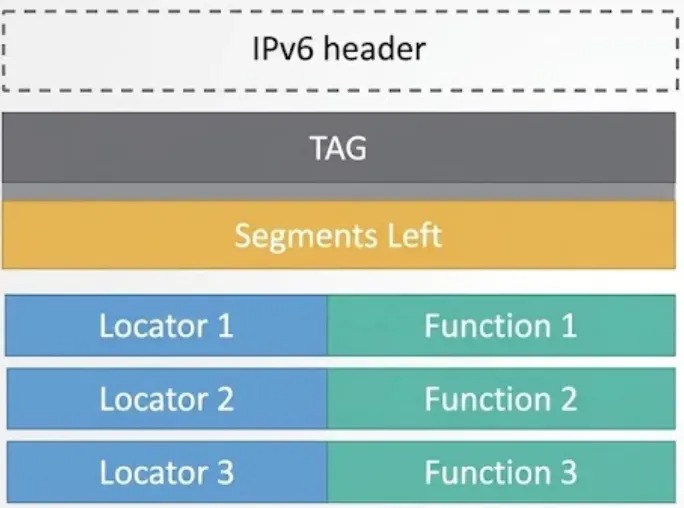
  • 显式路径指定: Ingress Leaf 或集中式控制器根据链路实时遥测(Telemetry)状态,在报文中压入一组经过无拥塞链路的 SID 列表(Segment List)。
  • 零状态中间转发: 中间 Spine 和交换节点只需机械地读取当前 SID 转发并执行指针偏移(Segments Left 减 1),完全不需要在核心交换机上配置和下发细颗粒度的流表。

 SRv6 Policy

4. SID 压缩技术:根治 MTU 损耗

SID 压缩技术

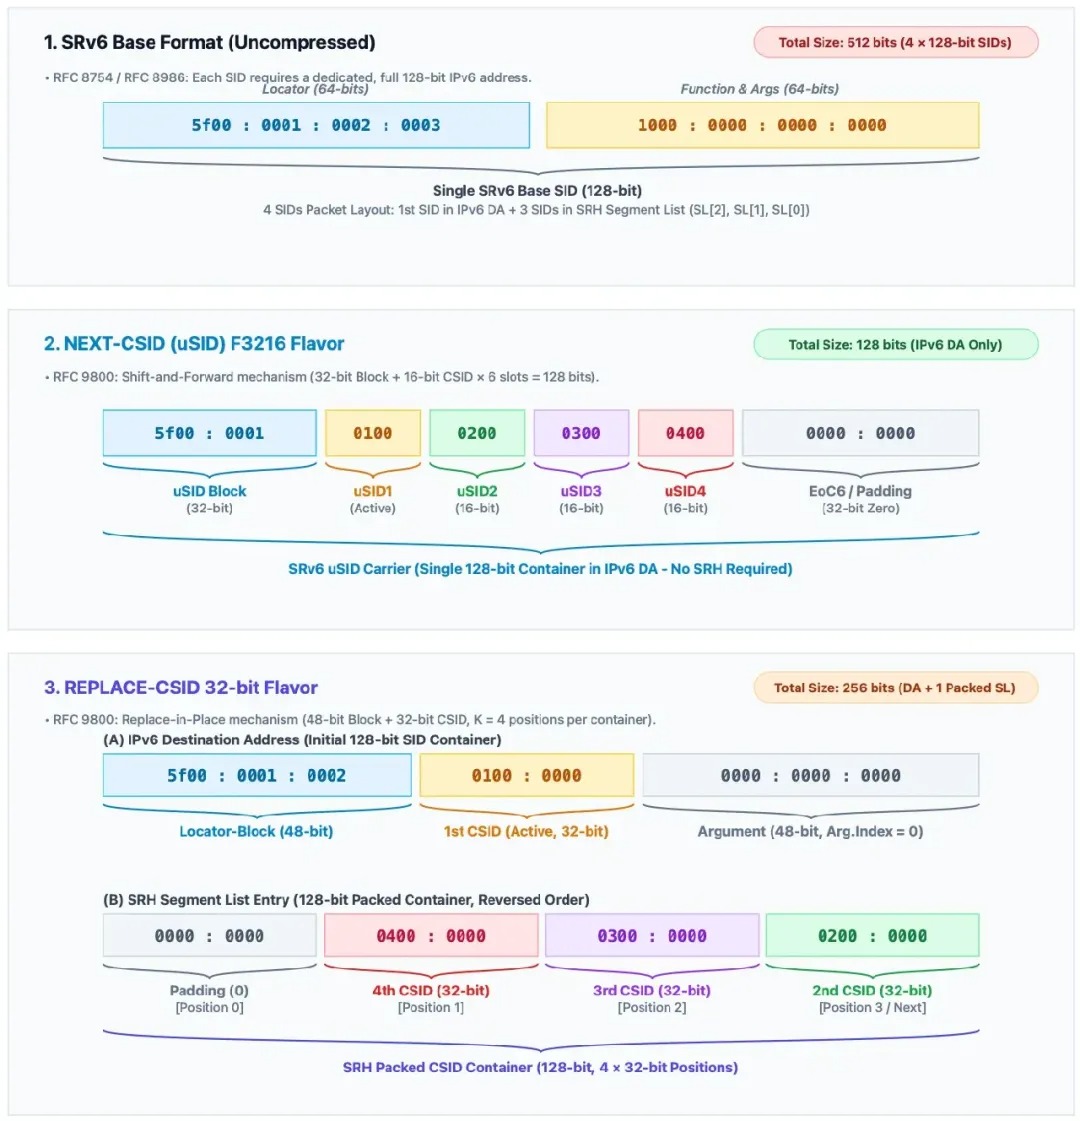
为解决标准 128-bit SRH 头过长导致的报文膨胀问题,RFC9800标准化了NEXT-C-SID和REPLACE-C-SID两种压缩机制。通过将多个节点的短操作码(如 16-bit 或 32-bit)打包在同一个 128-bit IPv6 目的地址中,显著压缩了报文开销,兼顾了传统短包吞吐率与 ASIC 硬件查表性能。

SRv6在数据中心的典型应用

1. 面向AI后端网络的SRv6应用——MRC架构

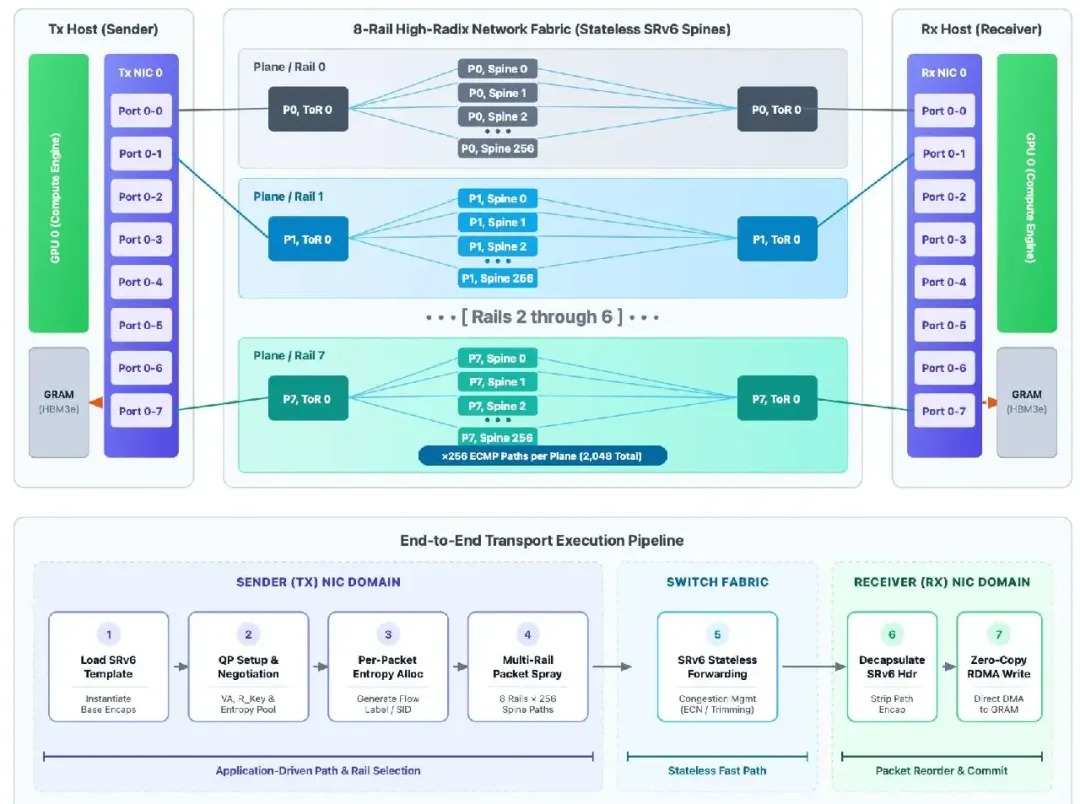
由OpenAI、微软、英伟达、AMD、英特尔和博通开发的MRC架构(Resilient AI Supercomputer Networking using MRC and SRv6)就是一个很好的例子。

SRv6的一个核心原则是让应用程序控制其网络体验。在传输层实现MRC可以创建一个可编程网络,其中传输栈为每个数据包选择路径。通过在许多无状态的路径和平面上分发数据包,MRC避免了传统基于ECMP部署中常见的因流量低熵值导致的流冲突问题。这是应用定义网络的实际应用,由SRv6引入的可编程性使能。

MRC架构

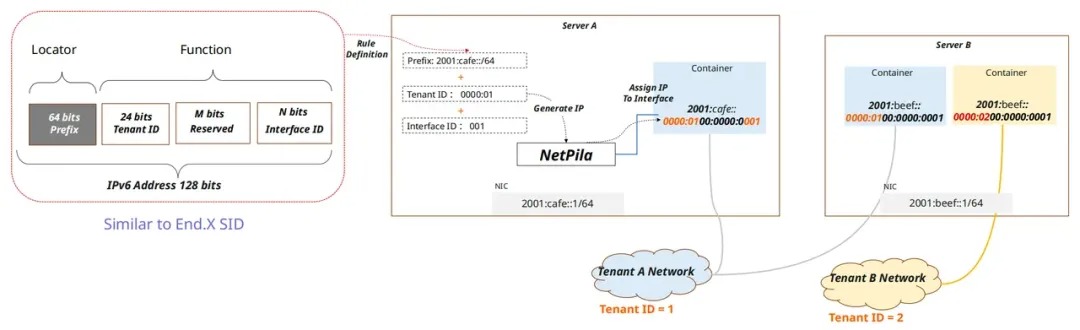
2. SRv6容器网络(Container Network)——NetPila方案

阿里云的NetPila展示了SRv6如何将容器网络提升到超越VXLAN隧道的水平——通过将租户和接口标识直接嵌入IPv6/SRv6地址模型,实现了Pod之间无需隧道的直接连接,并显著增强了端点与网络的集成紧密度。

NetPila方案

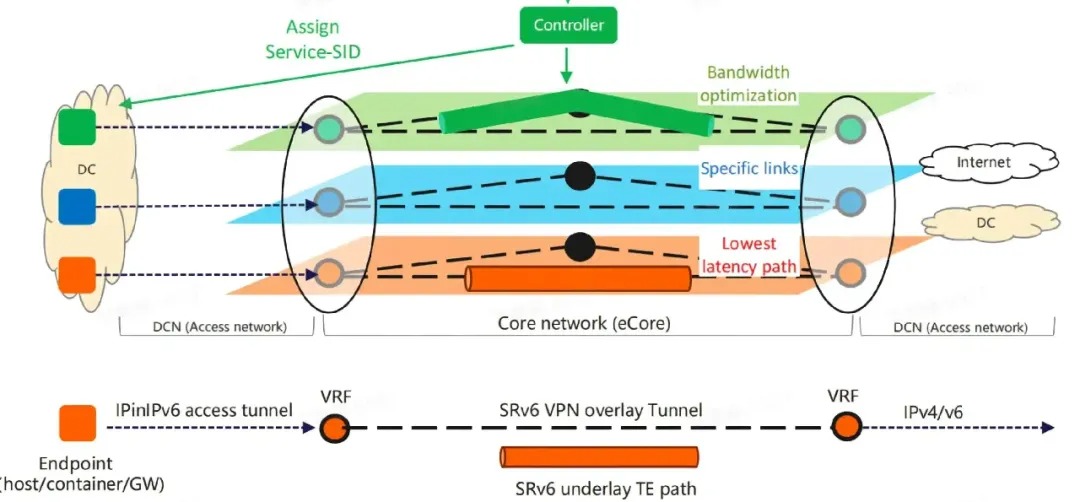
3. 基于SRv6的骨干/跨数据中心网络——eCore架构

阿里云的 eCore 是一个基于 IPv6/SRv6 的骨干/跨数据中心网络架构,通过统一的 IPv6 Underlay 和 SRv6 Traffic Engineering,将路径选择从传统的网络逐跳决策转变为可编程的端到端路径控制。

在 AI 场景中,eCore 进一步结合端网协同:服务器侧根据业务类型、QoS 等信息选择 Flow Label,由网络侧将 Flow Label 映射到不同的 SRv6 SID-List,从而实现 RDMA、高带宽、低成本等不同路径的精细化选择。

eCore架构

4. SRv6数据中心前端网络

SRv6数据中心前端网络

  • 彻底消除 DCI 性能瓶颈与协议断层:去除了 DCI 上的 EVPN-to-MPLS 复杂转换逻辑,DCI 降级为大容量普通 IPv6 路由器,消除多厂商在 DCI 互通时的协议兼容难题。
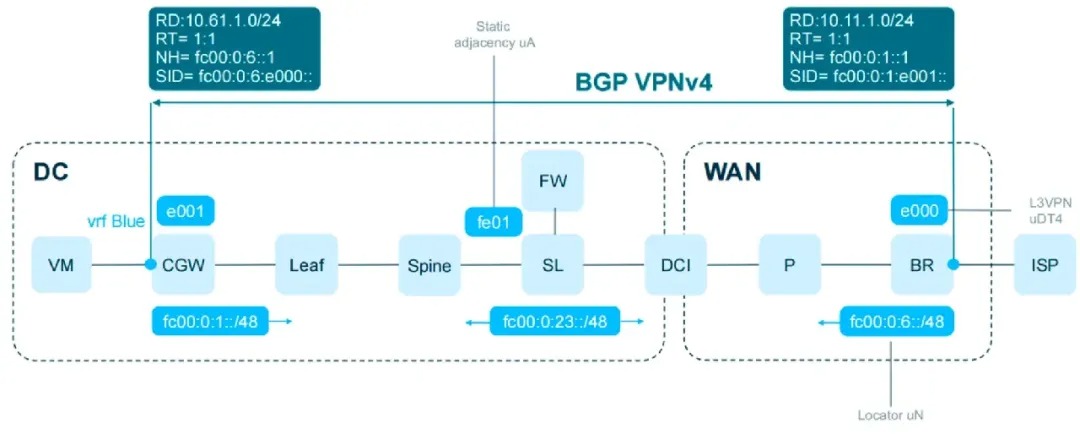
  • NFV 实例与服务链极简编排:云网关、防火墙等 NFV 实例天然运行在通用 Linux/x86 宿主机上,原生支持 IPv6/SRv6 内核处理,服务链引流由硬编码转向灵活的指令序列编排。
  • 业务下发与运维极度收敛:从“DC + DCI + WAN”三段式独立规划,转变为以业务为中心的端到端扁平化 L3VPN 架构。

SRv6数据中心前端网络

5. SRv6服务链(Service Chaining)

SRv6服务链(Service Chaining)

  • 将“服务”本身变成SID

这是最大的差异。在VXLAN网络中,服务节点(如防火墙)是拓扑中的一个“黑洞”,流量需要通过复杂的路由策略“扔”进去。而在SRv6中,每个服务节点或其特定接口都被分配了一个全球唯一的SID,服务链本质上就是将一个包含多个服务SID的Segment List附加在报文上,由网络自动完成编排。

  • 统一控制面与转发面

VXLAN Overlay网络通常需要独立的控制面(如EVPN),服务链策略也依赖于控制器下发。SRv6则实现了控制面(IGP/BGP扩展通告SID)和转发面(SID封装)的统一,简化了协议栈,使得网络能更自主地执行服务链策略。

  • “无状态”的服务链

传统服务链(如通过VRF手拉手)往往需要在服务节点上维护大量状态信息。SRv6的服务链是“无状态”的,路径和服务顺序完全由报文头中的SID列表决定,服务节点只需基于当前SID进行简单转发,无需维护每个流的状态,这大大简化了服务节点(尤其是第三方设备)的设计。

AsterNOS SRv6规格与路线图

为了实现上述端到端 SRv6 Fabric 的演进,星融元 AsterNOS 制定了清晰的 SRv6 特性演进路线图。目前,AsterNOS 已完整支持传统的 SRv6 和 REPLACE-C-SID 压缩,并计划于 2026Q4 全面支持 NEXT-C-SID (uSID),帮助企业构建面向 AI 算力时代的极简扁平化网络。

分类 子项 特性 支持
SRv6 端点行为 End Endpoint ✔
End.X Endpoint with L3 cross-connect (L3VPN) ✔
End.DT4 Endpoint with decapsulation and IPv4 table lookup (L3VPN) ✔
End.DT6 Endpoint with decapsulation and IPv6 table lookup (L3VPN) ✔
End.DT46 Endpoint with decapsulation and IP table lookup (L3VPN) ✔
End.DX4 Endpoint with decapsulation and IPv4 cross-connect (L3VPN) Q4
End.DX6 Endpoint with decapsulation and IPv6 cross-connect (L3VPN) Q4
End.DX2 Endpoint with decapsulation and L2 cross-connect (L2VPN) ✔
End.DT2M Endpoint with decapsulation and L2 broadcast (L2VPN) ✔
End.DT2U Endpoint with decapsulation and L2 unicast FDB lookup (L2VPN) ✔
SID压缩 uSID uSID (NEXT-CSID) compression Q4
G-SID G-SID (REPLACE-CScID) compression, 12 slots ✔
封装模式 H.Insert.Red Insert SRH in IPv6 with reduced encapsulation Q4
H.Encaps.Red Encaps SR headend with reduced encapsulation ✔
H.Encaps.L2.Red Encaps SR headend over L2 layer with reduced encapsulation Q4
节点Flavors USD Ultimate Segment Decapsulation ✔
COC G-SID mode, update DIP using compressed G-SID ✔
IGP路由协议 ISIS ISIS for SRv6 ✔
ISIS FRR Ti-LFA high availability ✔
OSPF OSPF for SRv6 Q4
OSPF FRR Ti-LFA high availability Q4
BGP BGP BGP for SRv6 ✔
SRv6-BE L3VPN L3VPN over SRv6-BE ✔
EVPN L2VPN VPLS (Type 1,2,3,4) Q3
VPWS (Type 1,4) Q3
CCC Q3
Multi-homing Q3
EVPN L3VPN Type 5 (IP Prefix Route) ✔
SRv6-TE Static TE Policy Static SRv6 TE Policy ✔
TE Policy Dynamic SRv6 TE Policy Q4
L3VPN L3VPN over SRv6-TE ✔
EVPN L2VPN VPLS/VPWS/CCC/Multi-homing over SRv6-TE Q3/Q4
EVPN L3VPN EVPN L3VPN (Type 1-5) over SRv6-TE ✔
Telemetry Telemetry Collect data from switch remotely ✔
BGP-EPE BGP-EPE Allocate SID for BGP peer ✔
BGP-LS SRv6 SID NLRI SRv6 SID Information / Endpoint Behavior / BGP Peer Node SID TLV Q4
Node NLRI SRv6 Capabilities / Node MSD Types TLV Q4
Link NLRI SRv6 End.X / LAN End.X / Link MSD Types TLV Q4
Prefix NLRI SRv6 SID Structure / Locator TLV Q4
PCEP PCEP for SRv6 path-setup-type / capabilities / RRO / ERO subobject TLV Q4
SBFD SBFD Seamless BFD Q4
SRv6 OAM SRv6 OAM Checking reachability to destination SID or PW Q4
Flex-Algo SRv6 Flex-Algo Custom IGP route calculation algorithms Q4
OAM工具 SID Ping SID reachability pinge Q4
SID Tracert SID path trace Q4
TE Policy Ping TE Policy reachability ping Q4
TE Policy Tracert TE Policy path trace Q4
TWAMP TWAMP Two-Way Active Measurement Protocol ✔

【参考文档】

MRC (Resilient AI Supercomputer Networking):

NetPila (阿里云 SRv6 容器网络) : https://datatracker.ietf.org/meeting/125/materials/slides-125-srv6ops-21-ipv6srv6-powering-alibaba-cloud-ai-computing-alibaba-02

eCore (阿里云 SRv6 骨干网):https://www.segment-routing.net/images/OCP-summit25-eCore_Alibaba.pdf


产品型号:数据中心交换机
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,数据中心,分布式存储
最后更新:2026-05-26


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

AIDC光模块选型与实践指南

速率、距离、封装、兼容性,四个维度讲透选型

光模块相关文章封面

给AI算力集群配光模块,最容易栽跟头。看着都是400G,接口也长得一样,插上就是不亮。机房一排GPU等着联网,整个集群的部署进度,就卡在这么一个小小的模块上。为什么?

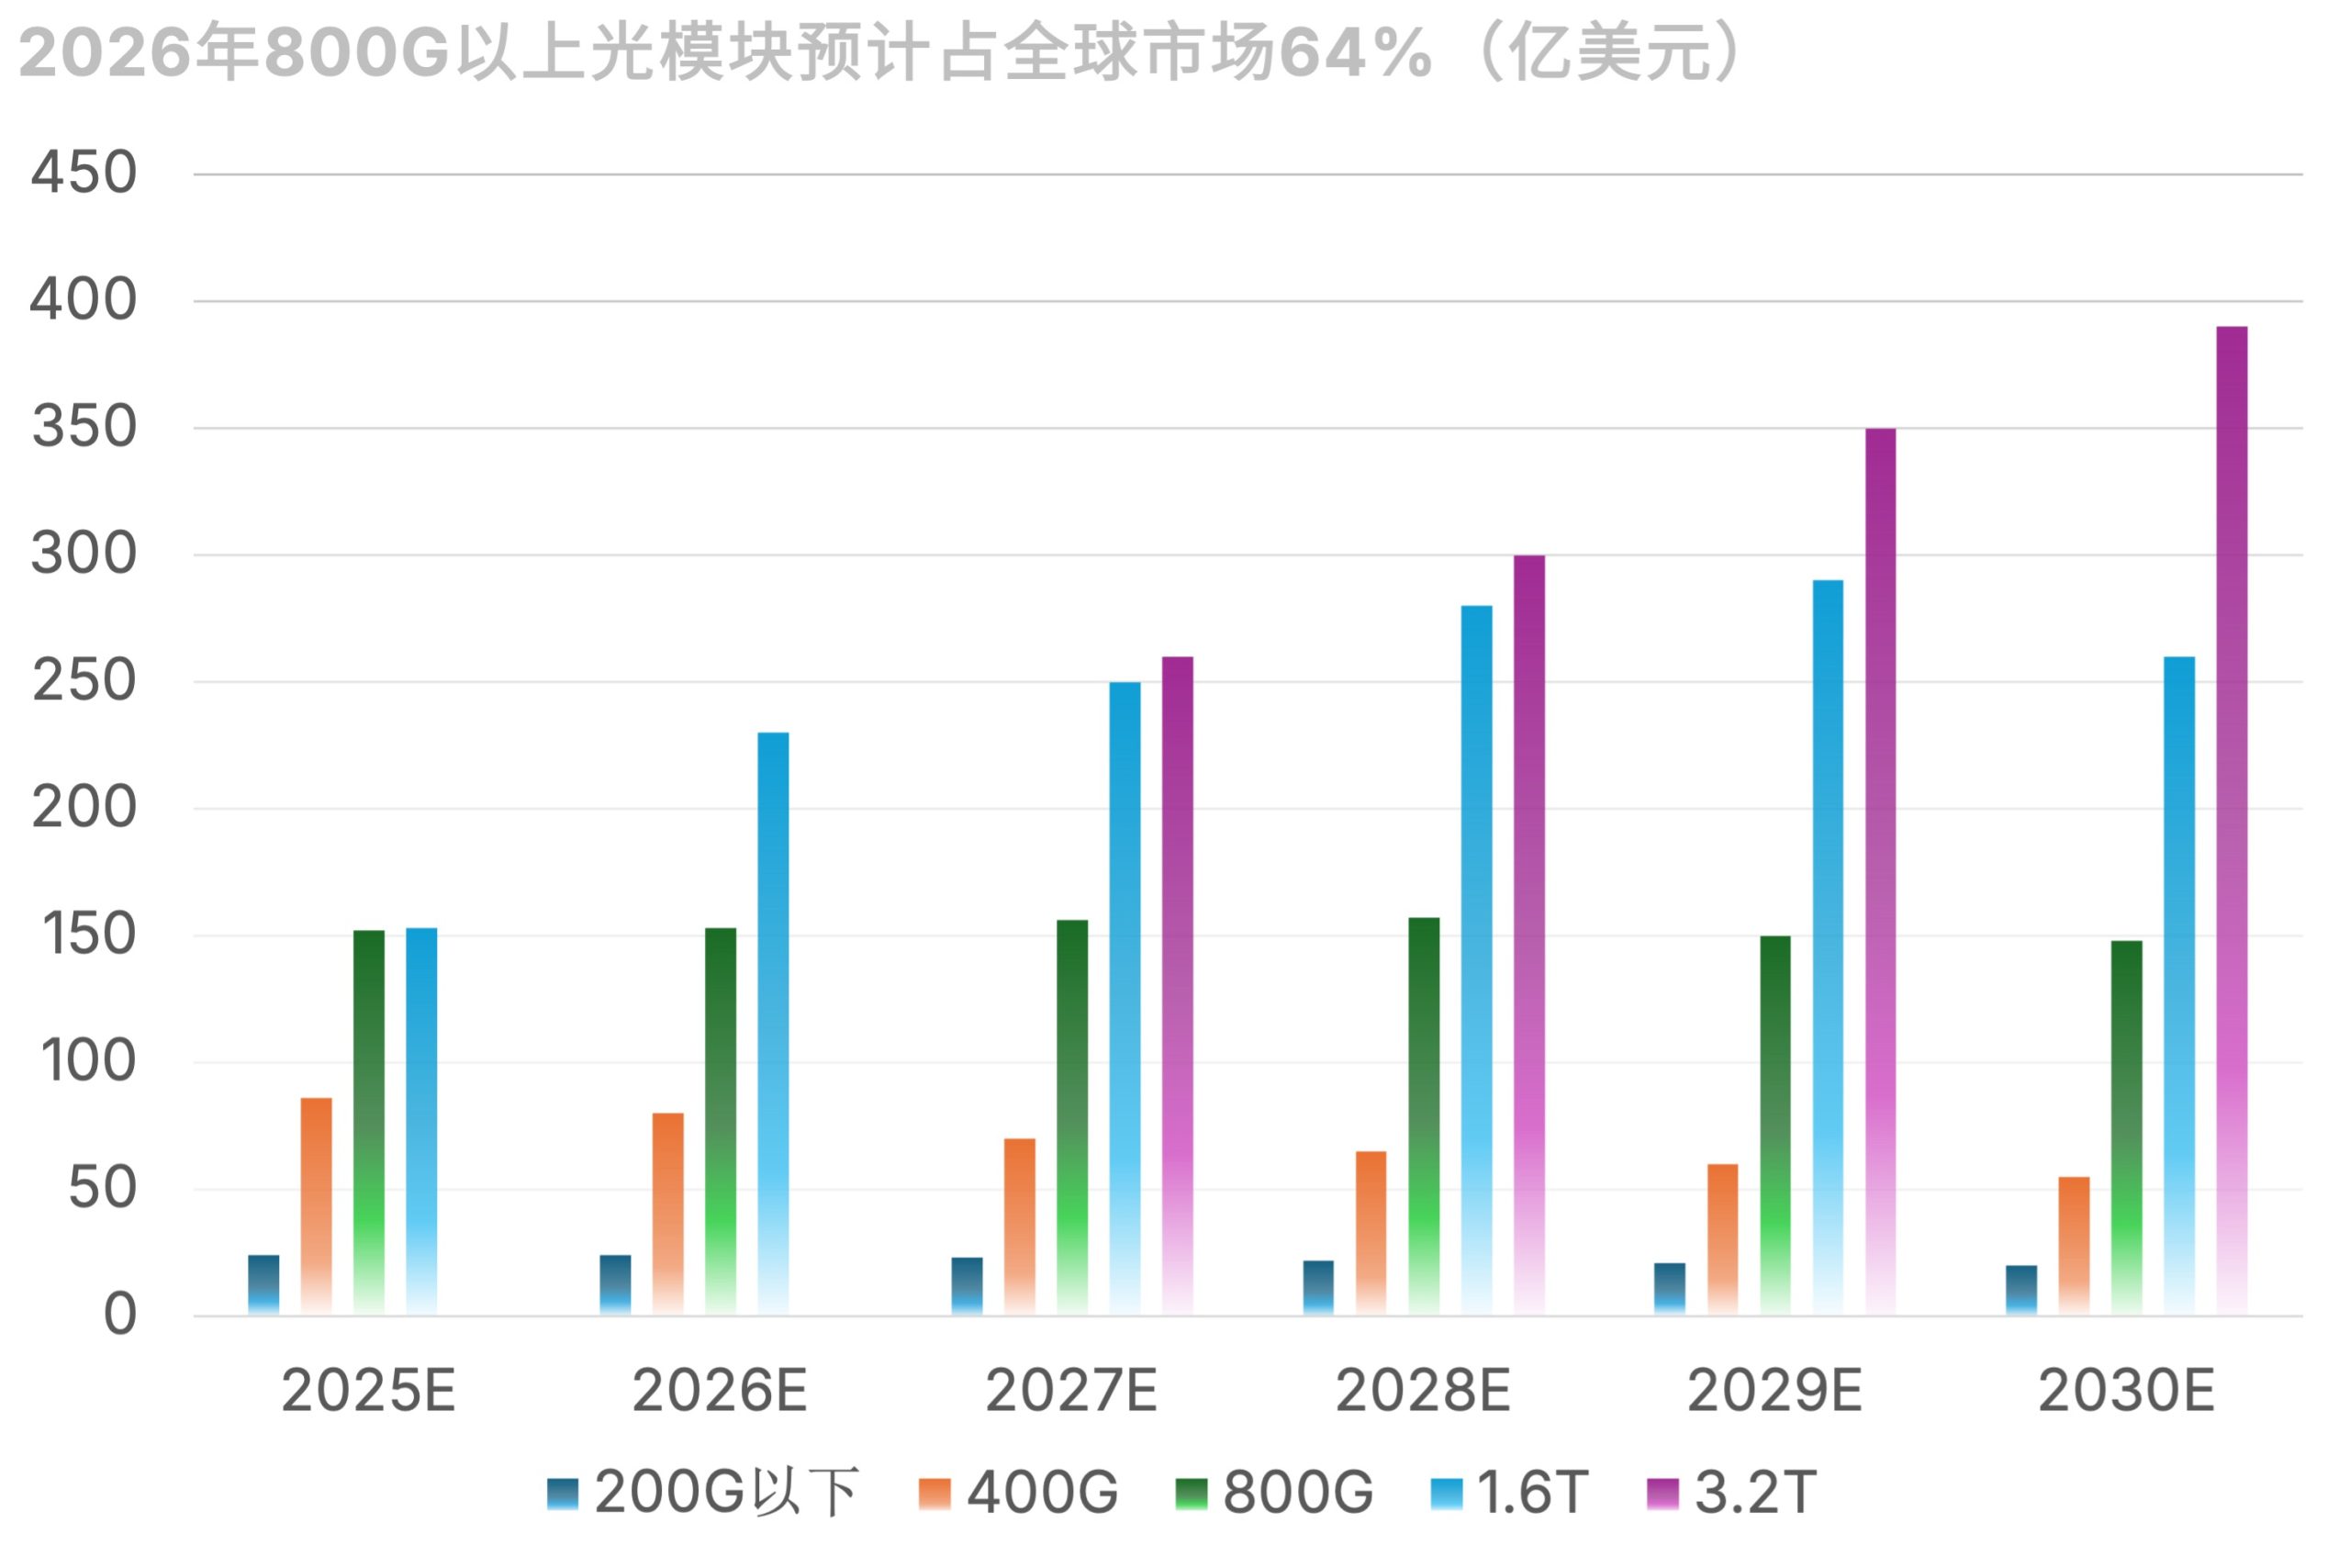
实际上光模块的参数远比看起来复杂。从100G到400G、800G,传输距离有SR、DR、FR、LR之分,封装有QSFP和OSFP,光纤还分多模和单模……任何一个参数不匹配,代价都是一条不通的链路。根据LightCounting的预测,2026年全球数通光模块市场规模有望达到228亿美元,800G和1.6T产品合计占比约64%。

LightCounting预测

来源:LightCounting,华泰证券

这篇文章内容基于一线数据中心的选型与部署经验,覆盖10G到800G的主流光模块,从技术原理、场景适配,到兼容性避坑和故障排查,逐一展开。

光模块基础知识

光模块的技术演进始终以速率为核心驱动力。从10G到1.6T,每一代产品都在为满足数据中心不断增长的带宽需求而迭代。目前数据中心最常用的光模块速率覆盖25G、100G、200G、400G和800G,1.6T光模块随着单端口1.6T交换机的推出,也将在2026年下半年逐步进入商用。

调制技术

调制技术是决定光模块速率上限的核心因素。当前主流的两种调制方式分别是NRZ(不归零编码)和PAM4(四电平脉冲幅度调制)。

  • NRZ使用两个信号电平(高和低),每个时钟周期传输1比特数据,误码率低但频谱效率仅为1 bit/symbol。它主要用于单通道10G到25G的速率场景。
  • PAM4使用四个不同的信号电平,每个时钟周期可传输2比特数据,频谱效率是NRZ的两倍。这使得PAM4能够在单通道上实现50G、100G甚至200G的速率。目前400G、800G和1.6T光模块均以PAM4调制为主。

💡 Tips: 如果你的网络需要25G以上单通道速率,基本可以锁定PAM4方案。但要注意,PAM4对信号质量要求更高,通常需要配合FEC(前向纠错)来保证链路稳定性。

速率级别 调制技术 通道数 核心应用与特点
10G/25G NRZ 单通道 传统企业数据中心服务器接入
40G/100G NRZ 4通道 传统云计算网络主力
200G/400G PAM4 4/8通道 云数据中心Spine-Leaf及早期AI集群
800G PAM4 8通道 高端AI集群(H100)
1.6T PAM4 8通道 下一代AI芯片(Blackwell),硅光主流

主流连接介质:DAC、AEC、AOC和标准光纤跳线如何选?

光模块之间的连接线缆主要有以下类型:

  • DAC(直连铜缆) :内部为纯铜线,无源设备。优点是成本低、功耗低、时延低;缺点是传输距离极短(高速率下衰减更快),且线缆较粗重。适合机柜内3米以内的短距连接。
  • AEC(有源电缆) :在DAC基础上增加了retimer芯片,线缆更细,传输距离可达5-7米,但仍属于短距方案。
  • AOC(有源光缆) :两端光模块与光缆一体化封装。重量轻、传输距离远(30-50米),是机房内机柜间连接的优选方案。
  • 多模光纤 (MMF, OM3/OM4/OM5): 配合SR(Short Reach)模块,适用于距离<100米的链路(如同一机房内)。
  • 单模光纤 (SMF, OS2): 配合DR/FR/LR/CWDM模块,适用于500米至10公里以上的。

💡Tips:3米以内选DAC,5-7米选AEC,30-50米可选AOC或标准光纤跳线,100米以上必须用标准光纤跳线配合对应的光模块。

光模块选型的核心指标

在实际选型中,速率和传输距离以及封装形态是最基本的考量指标。

模块型号的后缀种类:SR、DR、FR、LR、ZR

后缀 全称 传输距离 光纤类型 典型场景
SR Short Reach 小于100米 多模 机柜内、同列短距
DR Data Center Reach 500米 单模 数据中心机房内部
FR Far Reach 2千米 单模 跨楼层/跨楼宇
LR Long Reach 10千米 单模 跨园区
ZR Ultra Long Reach 80千米+ 单模 城域互联

其中DR模块是目前数据中心机房内部署最多的类型,兼顾了传输距离和成本效益。ZR模块采用相干技术,价格昂贵,主要用于城域间的超长距传输。

多模光纤 vs 单模光纤

  • 多模光纤配合SR短距模块,性价比高,适用于100米以内的短距链路。常用光纤规格为OM3、OM4、OM5。
  • 单模光纤配合DR、FR、LR等模块,支持更长距离传输和更完整的信号质量,但造价更高。

💡Tips:在传输距离能满足的前提下,优先选择多模方案以降低成本。当距离超过100米时,转向单模方案。

封装形态:QSFP与OSFP的选择

封装形态决定了光模块与交换机端口的物理兼容性:

  • QSFP系列(QSFP+、QSFP28、QSFP-DD):25G、100G、200G、400G均采用此封装,向后兼容性好。QSFP-DD在QSFP28外形上增加通道数实现400G,且向下兼容QSFP28。
  • OSFP:体积更大、散热更好,主要用在800G及以上的设备中。OSFP的散热优势使其成为NVIDIA AI网络和800G环境中的主流选择。OSFP最大功耗可达15W,比QSFP-DD高出3W。

💡Tips:QSFP和OSFP的物理外观完全不同,无法互相适配。如果是新建AI集群,OSFP是更面向未来的选择;如果是从现有QSFP基础设施升级,QSFP-DD的向后兼容性更有优势。

数据中心组网场景下的光模块选型实践

速率 典型模块 封装形态 介质与距离 接口 核心应用
800G 800G-SR8/DR8/2xDR4/LPO/AOC OSFP/QSFP-DD800 OM4 50m/OS2 500m-2km/AOC 1-30m MPO-16/MPO APC/LC 大模型训练集群H100/GPU互联
400G 400G-SR8/DR4/FR4/LR4 QSFP-DD 多模100m/单模500m-10km MPO-16/MPO-12 APC/LC 云数据中心 Spine-Leaf骨干
200G 200G-SR4/FR4/LR4/DAC/AOC QSFP56 多模100m/单模2-10km MPO-12/LC 200G IB HDR网络、汇聚层
100G 100G-SR4/CWDM4/LR4 QSFP28 多模100m/单模2-10km MPO-12/LC 云计算ToR接入与汇聚
10G/25G 25G-SR/LR/10GBASE-T SFP28/SFP+ 多模/单模/网线 LC/RJ45 边缘数据中心与老旧存储接入

Leaf-Spine架构的选型策略

在典型的Leaf-Spine二层组网中,不同层级的光模块选型策略截然不同:

  • Leaf到服务器(机柜内,3米以内) :服务器网卡(如100G CX5)与TOR交换机之间的连接,选型优先级为100G DAC > AOC > SR。DAC性价比最高。
  • Leaf到Spine(跨机柜/跨机房,50米-500米) :DAC不再适用,需要根据速率(如400G Spine)选择对应的单模模块(DR或FR),配合单模光纤。

AI算力集群800G光模块选型

大模型训练驱动的AI算力集群对光模块提出了更高要求:

  • 计算节点(如NVIDIA H100,8张800G网卡)与交换机之间:短距连接,选择800G SR模块,配合多模光纤。
  • Spine层之间:传输距离更长,需要选择800G DR8或2×DR4模块,配合单模光纤。
  • 800G端口支持breakout拆分(如800G拆分为4×200G)时,需确认交换机是否支持对应的拆分模式。

光模块兼容性

光模块的兼容性是数据中心部署中最常见也最棘手的问题之一。

许多交换机大厂会在交换机上设置光模块白名单——只有通过认证的模块才能正常工作。白名单校验机制包括:

  • 基础信息校验:vendor name、OUI、PIN码
  • 更深入的CCBASE和Extended校验
  • 部分厂商甚至采用加密校验

一旦校验失败,交换机会采取拒绝供电、标记为unsupported、限制功能等锁定策略。

如何躲开兼容性“陷阱”?

  1. 优先选择:使用交换机厂商认证或推荐的光模块品牌
  2. 修改模块EEPROM:部分情况下可通过重写光模块的EEPROM信息绕过校验
  3. 更换模块:如果模块被锁定且无法修改,只能更换为兼容模块

光模块故障排查

在数据中心部署过程中,光模块无法Link Up很常见。建议按以下流程进行自检:

步骤
检查要点与指导
1、光纤/模块匹配性
确认单/多模匹配;光纤长度与传输模式一致
2、线缆物理状态
外观无损、无扭曲、插头清洁且卡扣完好;必要时自环测试
3、模块物理清洁/测试
金手指清洁无尘;建议两端使用相同厂商模块
4、光功率阈值
检查收发光功率是否在Threshold内;确认TX-RX未接反
5、误码率/信噪比
BER<1e-9,SNR>20db,确保信号纯净度
6、端口管理状态
查看Admin状态,Monitor-Link组关联及errdown原因
7、FEC/自协商一致性
核对两端速率、拆分模式、自协商及FEC配置镜像一致

做完以上步骤仍无法解决,大概率是兼容性问题,需要考虑更换模块品牌或联系厂商技术支持。

CMIS管理机制

CMIS(Common Management Interface Specification)是高速光模块的一种标准管理配置协议。它定义了光模块与系统管理软件之间的接口和数据格式,使得不同厂商的光模块可以通过统一的方式进行配置、监控和管理。

数字诊断监控 (DDM/DOM)

提供实时性能监测数据,包括:

  • 温度 (Temperature):模块内部温度监控
    电压 (VCC):供电电压监控
  • 光功率 (Optical Power):Tx(发射)和 Rx(接收)的实时光功率值,用于判断链路质量
  • 偏置电流 (Bias Current):激光器工作状态监测

配置与控制 (Configuration)

允许 Host 对模块进行动态配置,例如:

  • 通道速率设置:配置 Lane 的波特率和调制方式(如 PAM4)
  • 功耗控制:在不同功耗模式(Low Power vs. High Power)之间切换
  • 发射/接收控制:通过 Tx/Rx Disable 命令开关光路

状态机控制 (State Machine)

  • 定义了模块从上电到完全工作的详细生命周期(如 Reset -> Initializing -> Ready -> Operational)
  • Host 通过读取模块的“状态机”状态,可以清晰判断模块是否已准备好发送数据,或者是否遇到了故障

💡Tips:25G、100G等低速模块通常不需要CMIS配置,即插即用。但400G及以上高速模块强烈建议开启CMIS管理,否则可能遇到各种“莫名其妙”的Link Up问题。


产品型号:数据中心交换机
功能特性:RoCEv2, PFC, ECN, DCBX ……

应用场景:GPU算力集群,数据中心,分布式存储
最后更新:2026-05-26


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

一文读懂 MPLS:下一代园区网络的高速转发引擎

告别VLAN堆叠与路由延迟,构建下一代多业务融合网络

MPLS文章封面

让我们设想一下:在同一张物理网络上,要同时跑通办公、安防、物联网和核心生产业务,还要保证绝对的业务隔离与极低的延时,是继续堆叠VLAN?还是靠复杂的路由策略维持?在多业务融合的狂潮下,传统IP网络有些力不从心。

改变局面的,并非什么凭空出现的新概念,而是曾经横行骨干网的“老将”——MPLS。当MPLS走下神坛进入企业园区,它究竟能为现代网络架构带来怎样的变化?

传统园区 IP 网络为何力不从心?

在探讨MPLS之前,我们需要了解当前企业网络面临的真实困境:

  • 路由查询瓶颈制约转发效率

传统IP路由采用最长前缀匹配算法。数据包在每个节点都需停下来“问路”(查表),极大地消耗了软件查找资源。效率低下成为网络高速发展的最大瓶颈。

  • VLAN 硬性数量限制导致隔离能力触底

现代园区(如高校、多租户科技园)内部业务繁杂。传统VLAN技术最多只能支持4094个网段,在面对成千上万个独立项目组或租户时,无法满足细粒度及高安全的硬性隔离需求。

  • 跨域连接与专线管理复杂

许多企业在进行多分支机构互联或混合云接入时,高度依赖物理专线,使得跨域网络的路由策略与安全边界管理变得非常繁琐。

MPLS 功能解析:“2.5层”标签交换的优势

多协议标签交换MPLS(Multiprotocol Label Switching)是一种IP骨干网技术。它的核心创新在于,在无连接的IP网络上建立了面向连接的“标签”通道,既保留了三层IP路由的灵活寻址能力,又具备了二层交换机的极简与高效。

从“复杂拆包”到“极速流转”

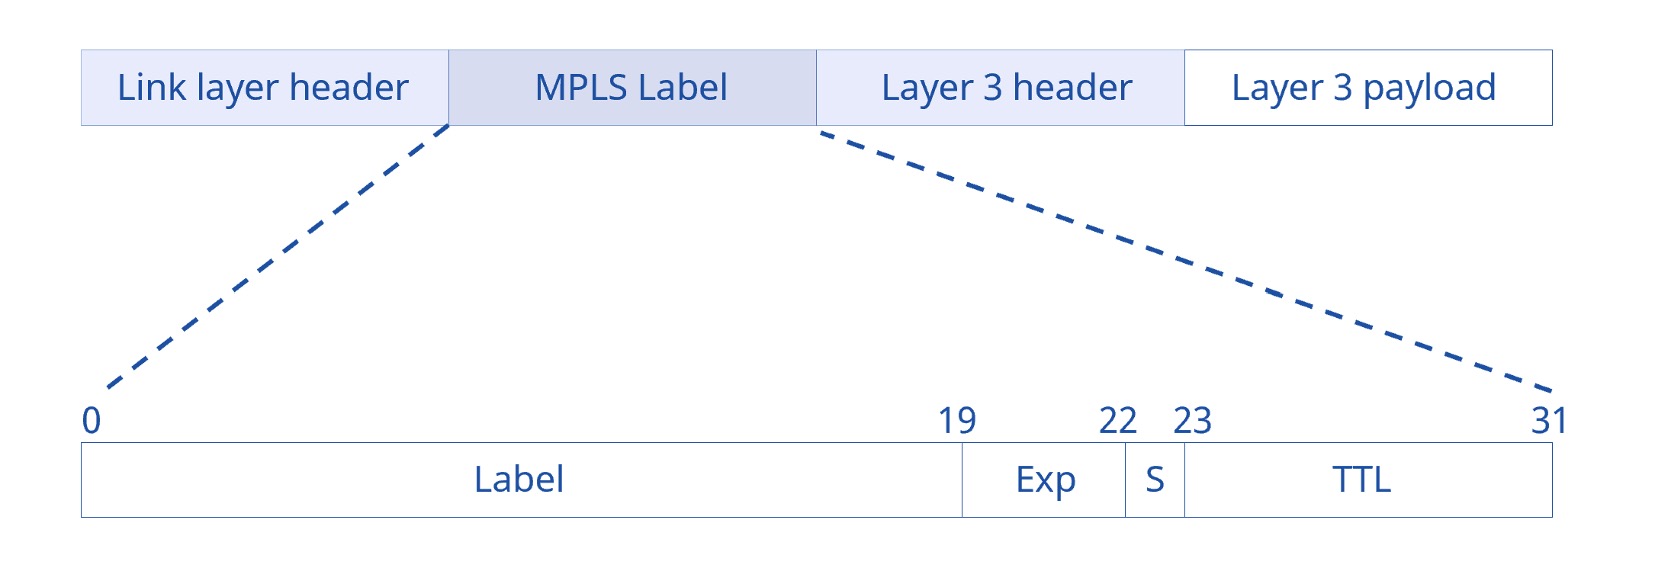
MPLS在二层与三层头部之间插入了一个长度固定的MPLS标签,因此常被称为“2.5层”协议。

MPLS在报文中的位置

MPLS在报文中的位置

在MPLS核心网络中,设备无需剥离和解析复杂的三层 IP 头部。仅需读取定长的 MPLS 标签,即可在硬件层面完成精确、极速的“交换(Swap)”动作,彻底解决传统 IP 路由“最长前缀匹配”带来的性能瓶颈。

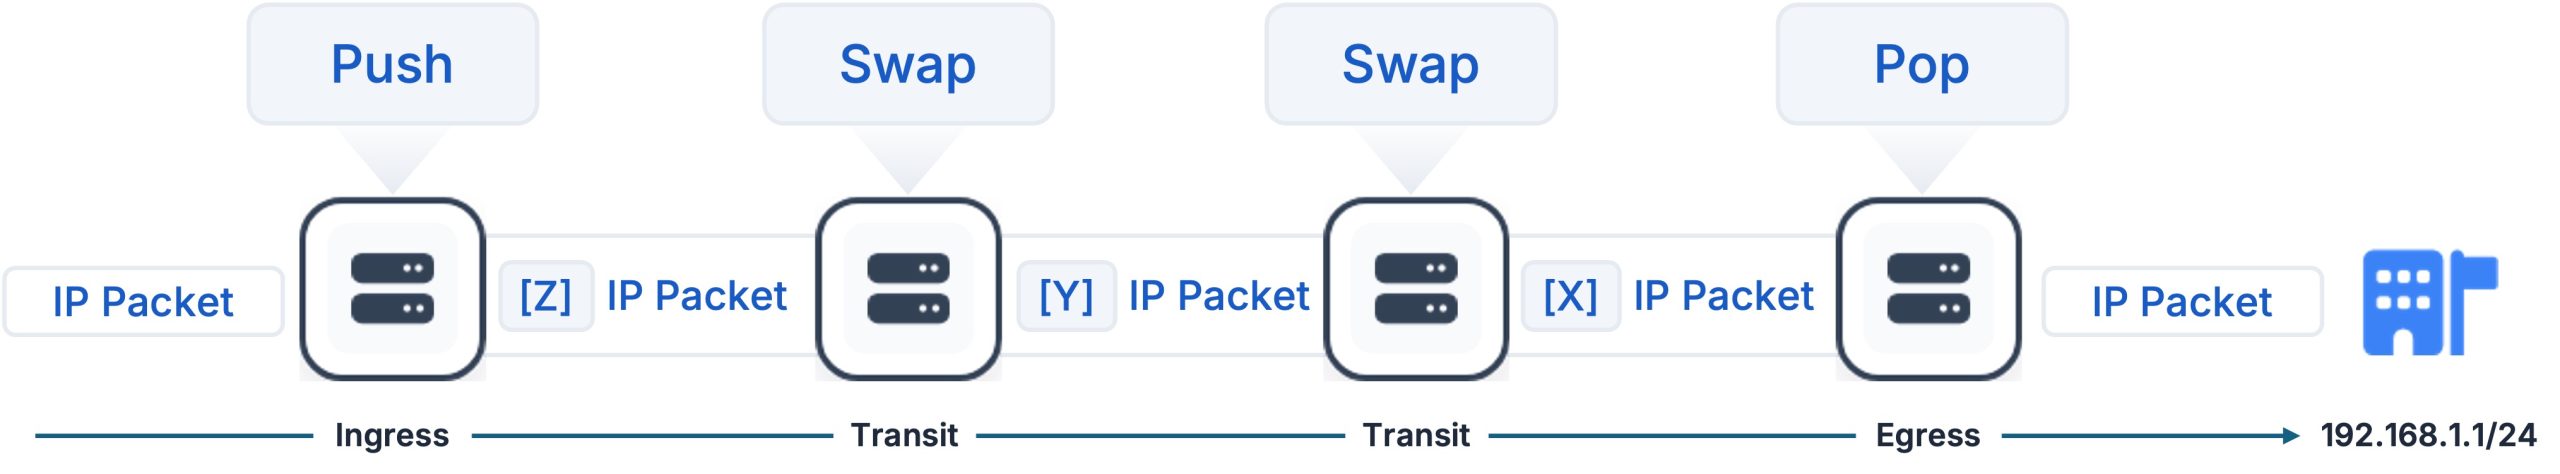
数据交换过程

  • Push:当IP报文进入MPLS域时,MPLS边界设备在报文二层首部和IP首部之间插入一个新标签。
  • Swap:当报文在MPLS域内转发时,根据标签转发表,用下一跳分配的标签,替换MPLS报文的栈顶标签。
  • Pop:当报文离开MPLS域时,将MPLS报文的标签剥掉。

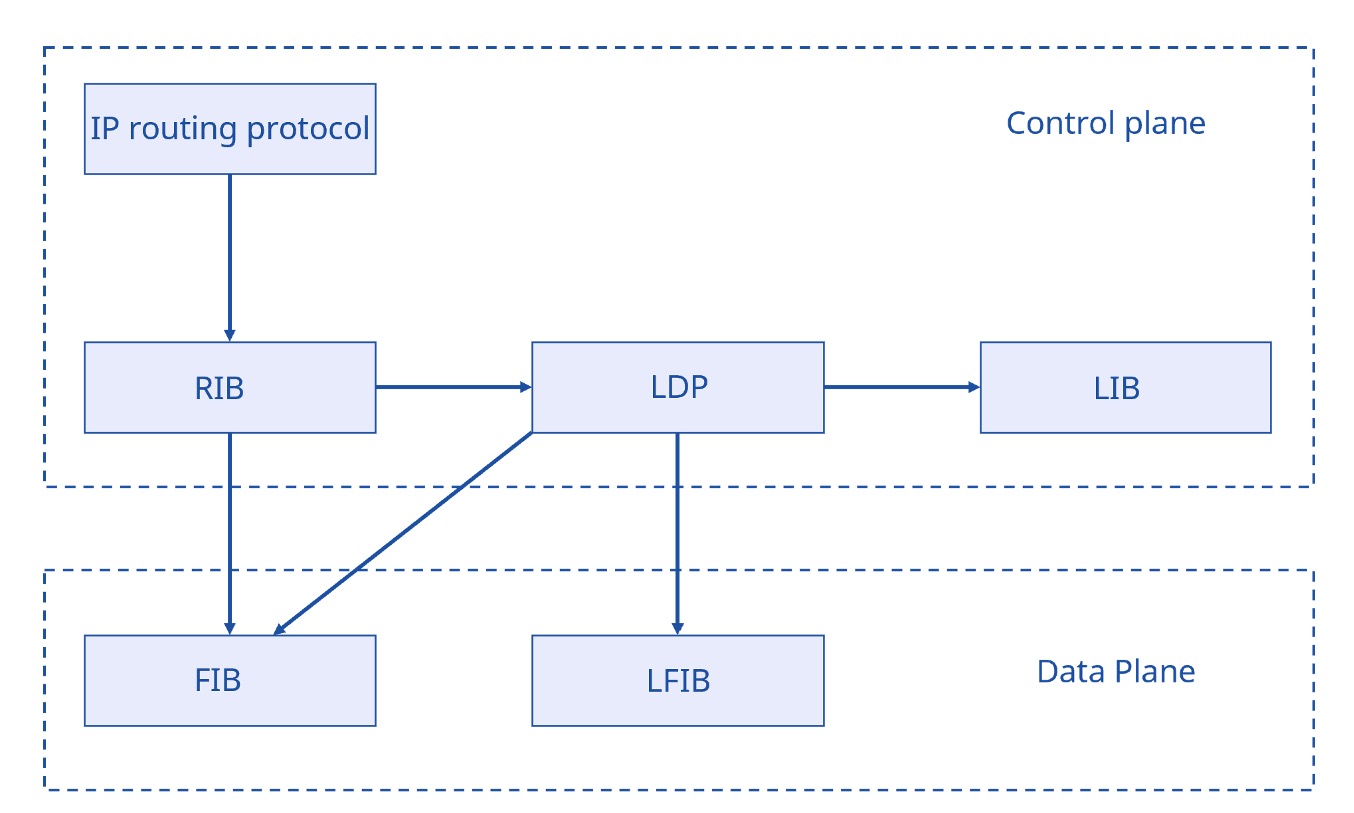
控制平面与转发平面解耦

MPLS架构内部逻辑划分

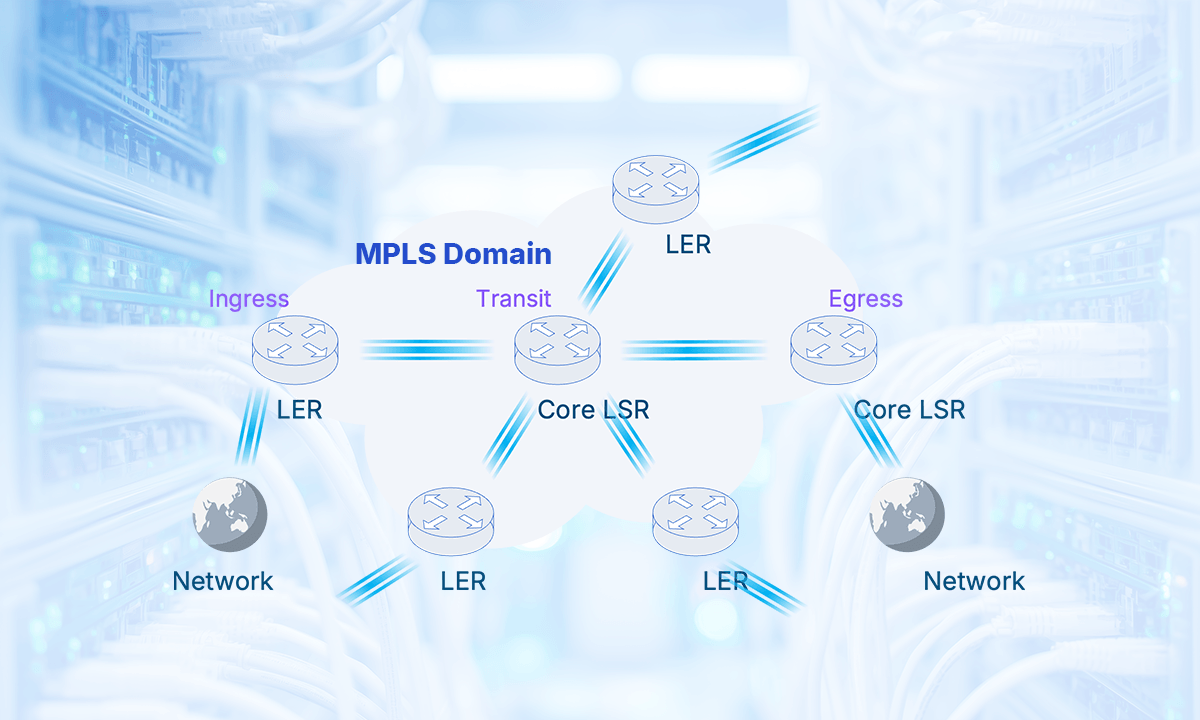
MPLS架构的网络设备

MPLS架构将网络设备的内部逻辑划分为两层:

  1. 控制平面负责产生和维护路由及标签映射信息。
  2. 转发平面只负责实际的报文转发。

这种解耦架构确保了极高的系统稳定性——控制平面的任何计算波动,都不会影响底层数据包的高速流转。

MPLS 如何重塑园区网络体验?

除了速度上的飞跃,MPLS功能的下沉为园区网络带来了更高的性价比与坚固的安全性。

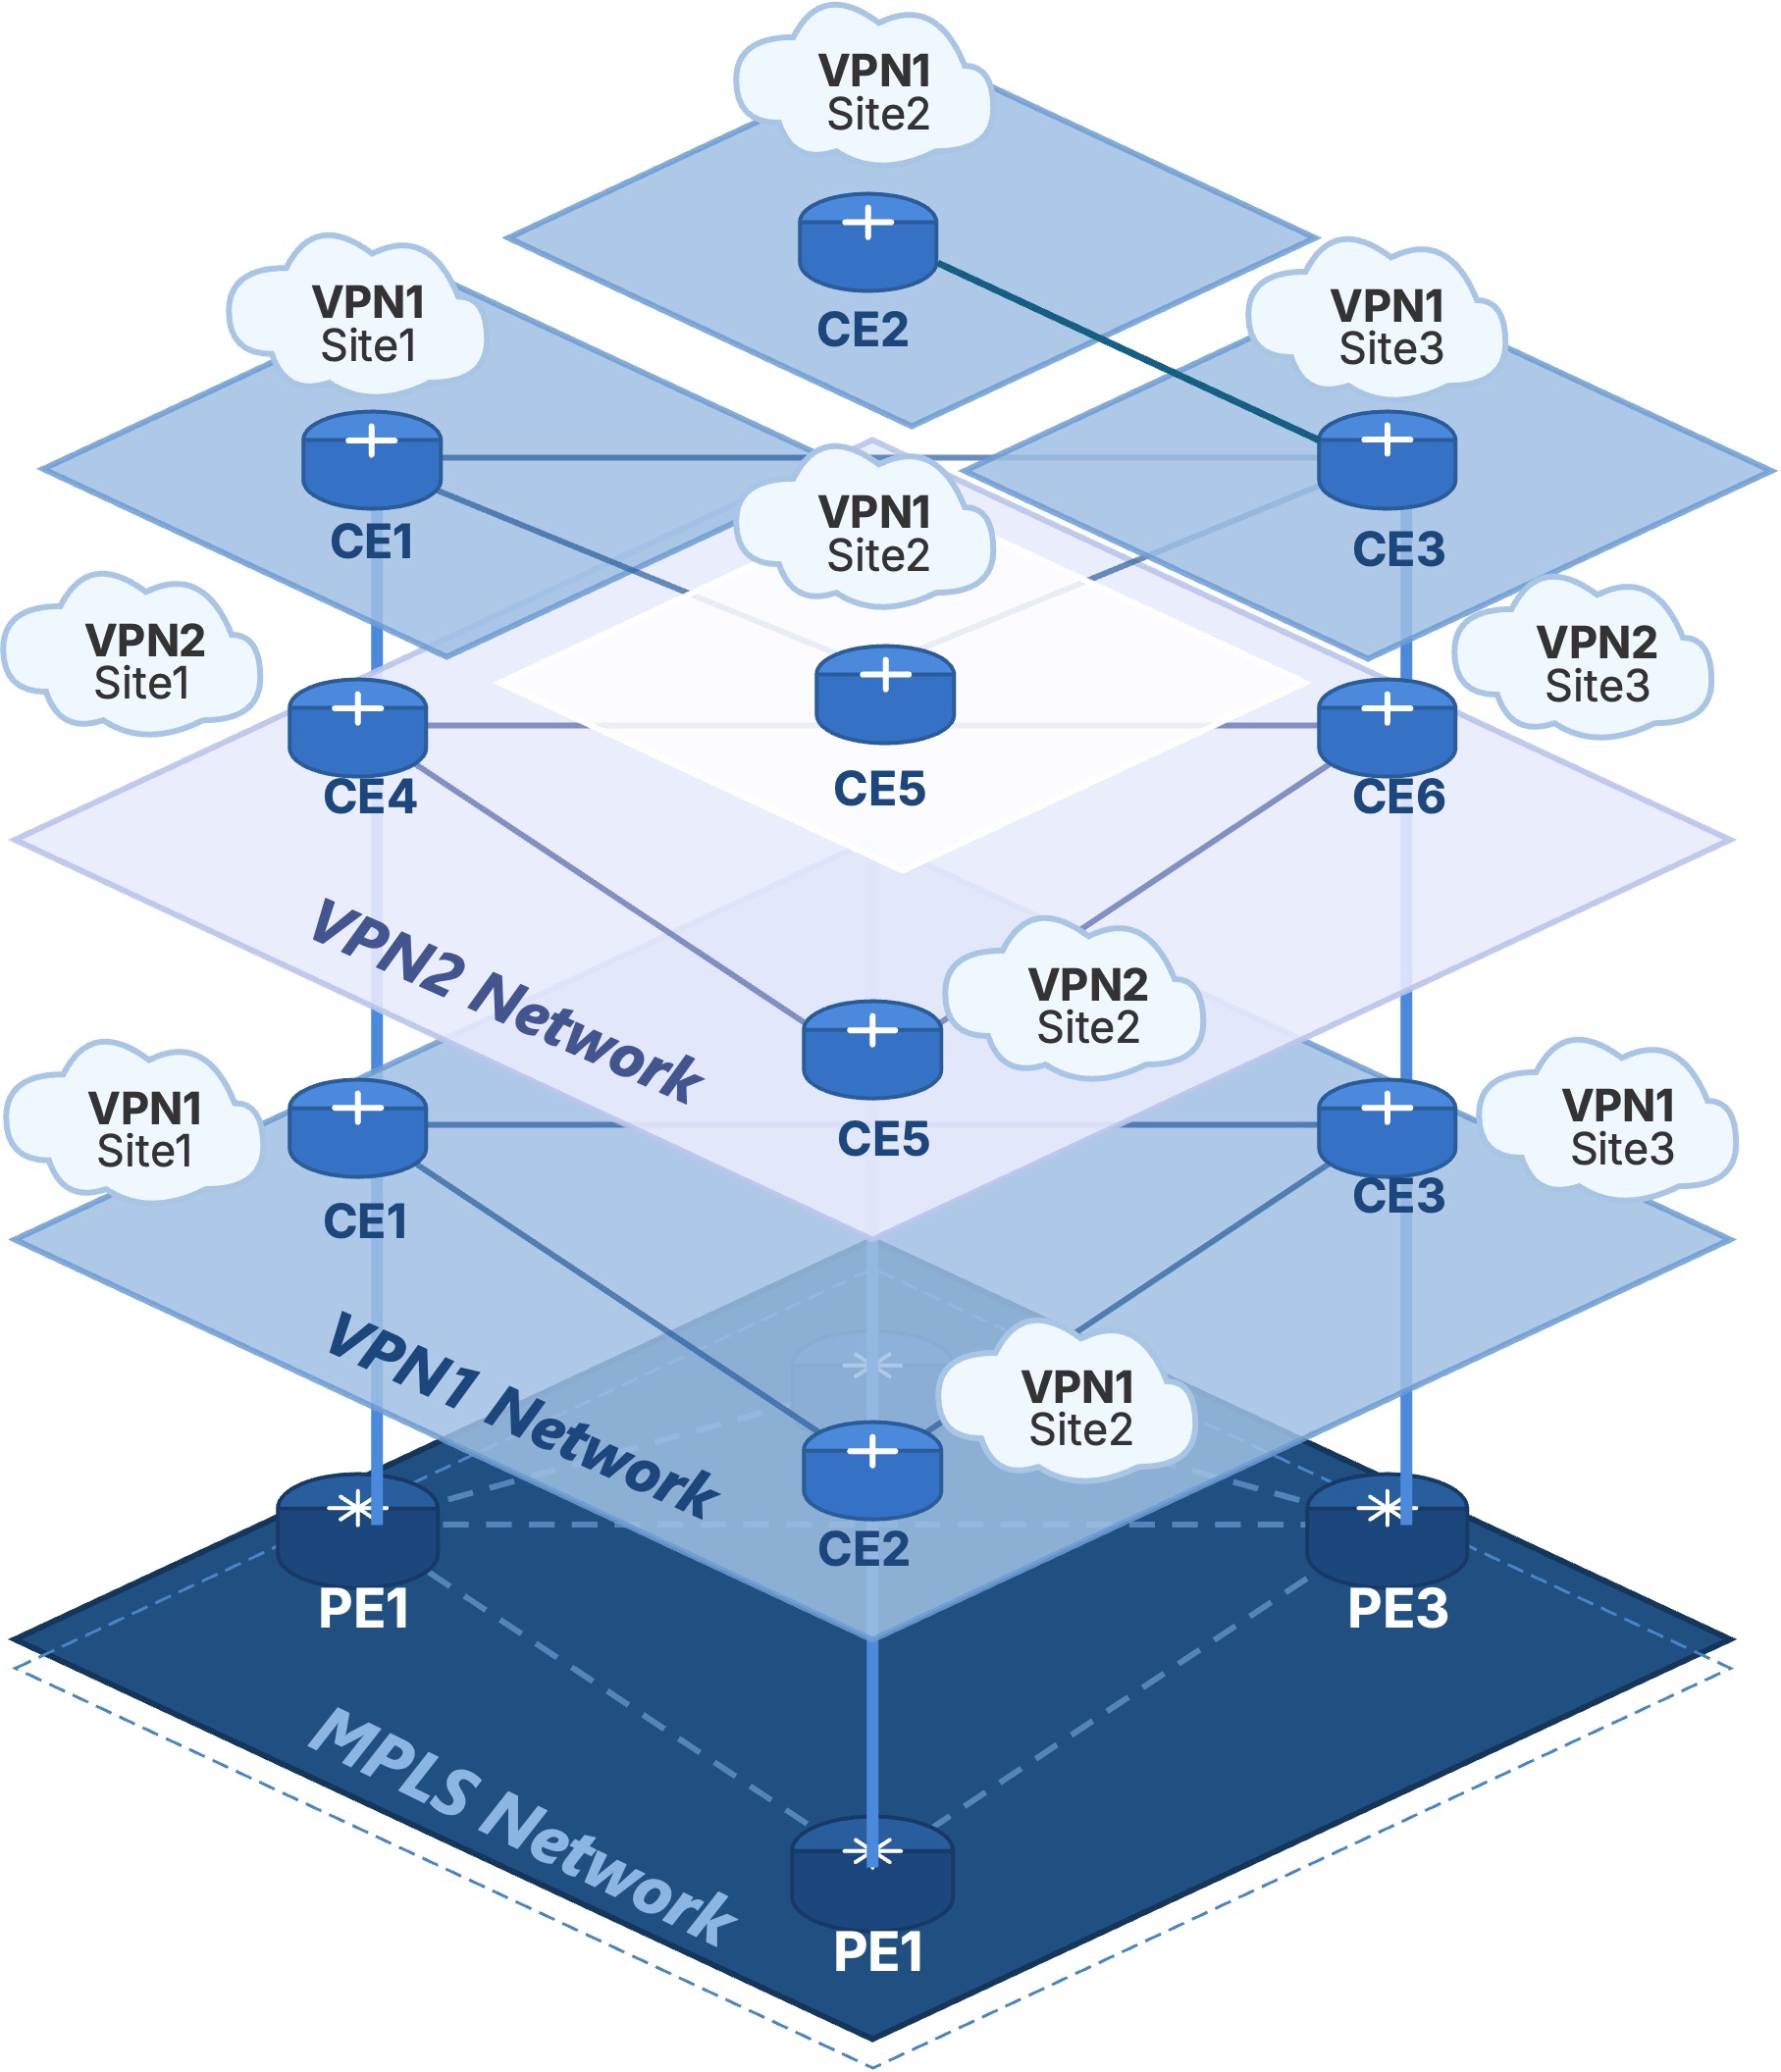
L2/L3 VPN 突破物理隔离天花板

海量业务绝对隔离

海量业务绝对隔离

借助MPLS的VPN技术(支持L2VPN的VPWS/VPLS,以及L3VPN),企业可以在同一张物理网络中,逻辑切分出成千上万个完全不可见、相互独立的虚拟网络。

这不仅满足了多部门的绝对隔离需求,更避免为了不同业务而重复购买设备与拉线,降低企业的总体拥有成本(TCO)。

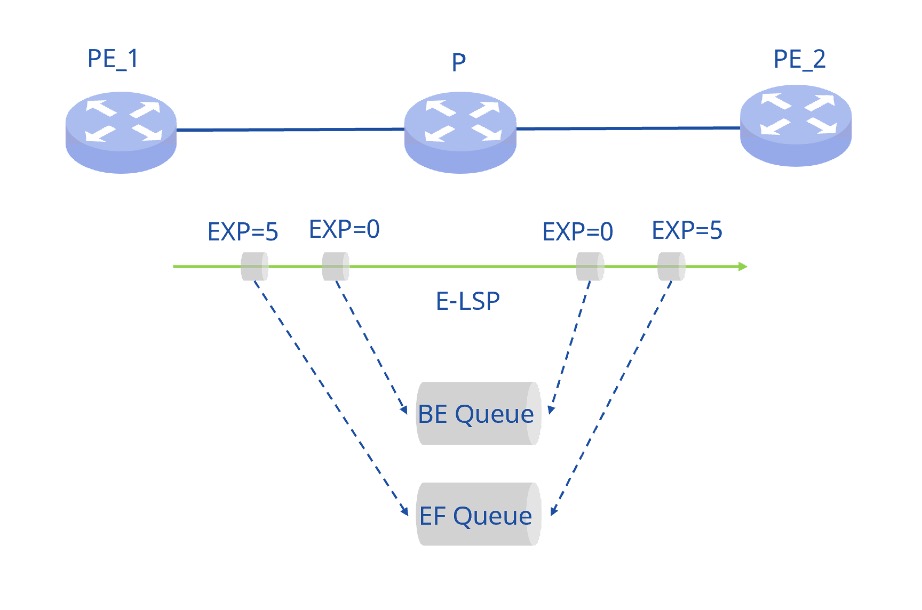
精细化 QoS 与网络安全保障

精细化QoS

精细化QoS

既然一套物理网络要承载多业务,就必须确保核心业务不卡顿。MPLS方案提供了严格的优先级梯队划分:关键业务可配置零丢包保障,而低优先级业务则进行尽力转发。

PHB行为 调度策略与网络承诺 典型应用
CS7/CS6 7/6 零丢包特权保障 BGP, OSPF, IS-IS等路由协议报文及核心链路控制流量
EF 5 极低延迟与硬隔离 实时语音(VoIP)、企业跨地域4K高清双向视频会议
AF4-AF1 4/3/2/1 弹性带宽按需预留 核心ERP、数据库同步、金融交易、高价值VIP客户数据
BE 0 填补剩余资源空间 普通网页浏览(HTTP)、大文件后台传输、普通电子邮件

此外,MPLS还具备抵御篡改的安全功能,例如在LDP会话中引入MD5信令验证机制。设备间在TCP层面进行严格的密码比对,彻底杜绝黑客伪造设备身份的可能,保障全网安全。

典型的 MPLS 园区跨域应用场景

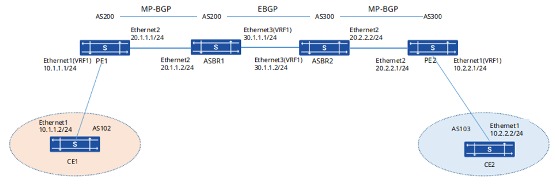
针对多分支园区的跨域互联,MPLS提供了行业标准的跨域L3VPN方案,目前主流应用为 Option A 与 Option B 两种模式:

  • Option A(背靠背VRF互联): 两端边界路由器(ASBR)之间运行普通的eBGP和IPv4协议。此方案无需中间链路支持MPLS,非常适合中间跨越第三方运营商普通专线,或园区内设备分批升级(一端支持MPLS,一端不支持)的场景,实现业务快速对接。

背靠背VRF互联

背靠背VRF互联

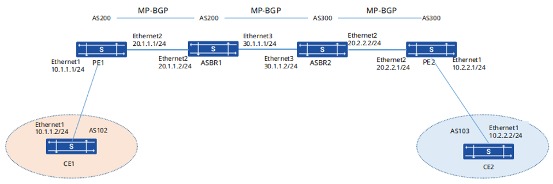
  • Option B(MP-BGP标签传递): 两端设备直接通过MP-BGP(多协议BGP)交换带标签的路由。无论两端划分了多少个需要隔离的部门,只需在中间建立一个BGP会话即可全部穿透对接。对于对中间设备有绝对控制权的自建跨地域网络而言,该方案扩展性极强,配置也更为简便。

MP-BGP标签传递

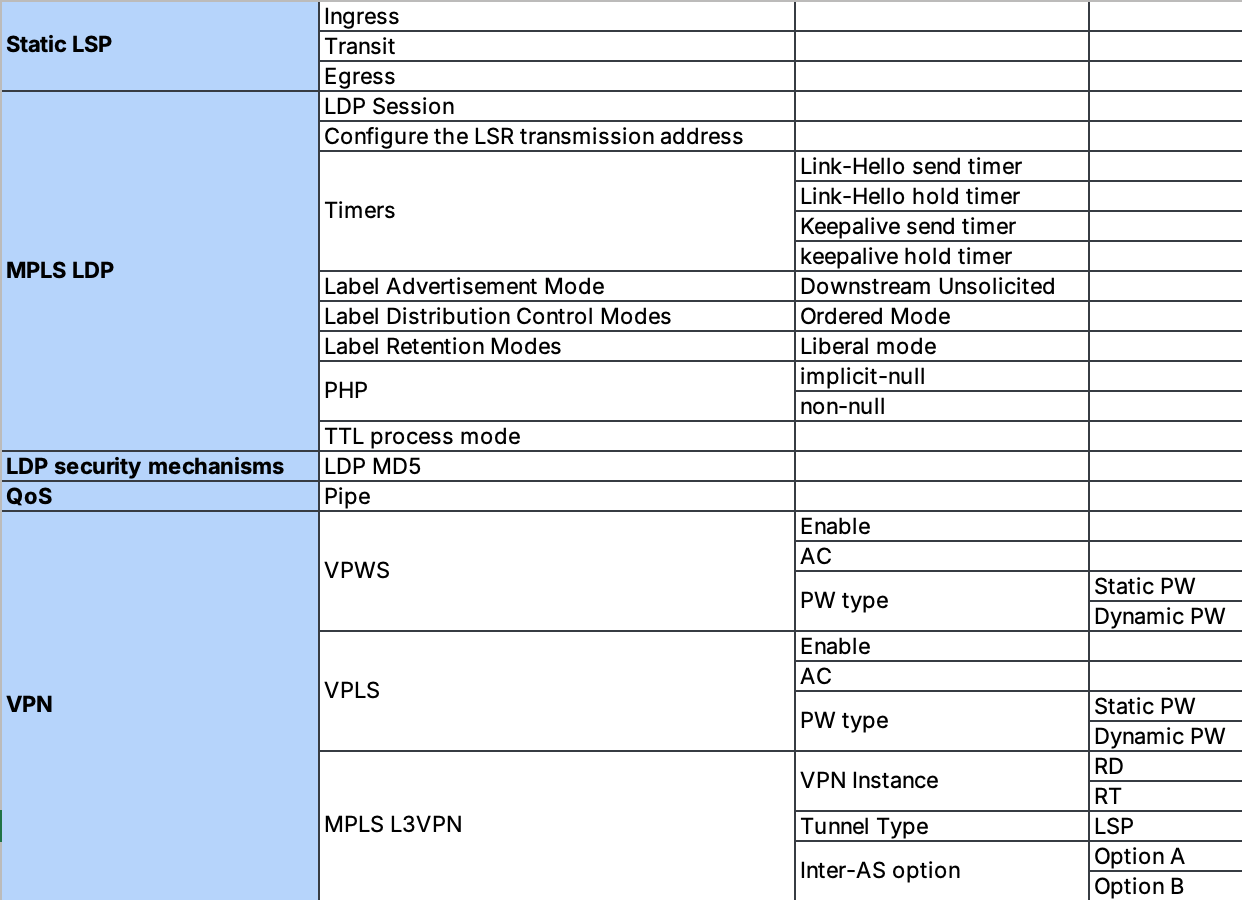
【MPLS 特性列表】

MPLS特性列表

值得一提的是,现代的MPLS方案正基于开放的SONiC架构平滑落地。它打破了传统设备的黑盒状态与软硬件绑定,提供业内标准的命令行界面,网络工程师无需极高的学习成本即可轻松运维。

参考产品:CX-M系列云化园区交换机:构建新一代精简高效的云化园区网络


产品型号: 星融元(Asterfusion)ET3600系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……

应用场景:企业路由器,路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


产品型号: 星融元(Asterfusion)ET2500系列智能网关平台
支持协议:PTP,IPSec,SSL/TLS……

应用场景:路由器,防火墙,VPN网关,负载均衡器,IDS/IPS,网络流量分析器
最后更新:2026-05-18


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

AIDC 网络运维平台全新发布:自动化极简开局、RoCE 灵活调参和网络可观测

赋能大规模智算网络的高效运维与自动化部署

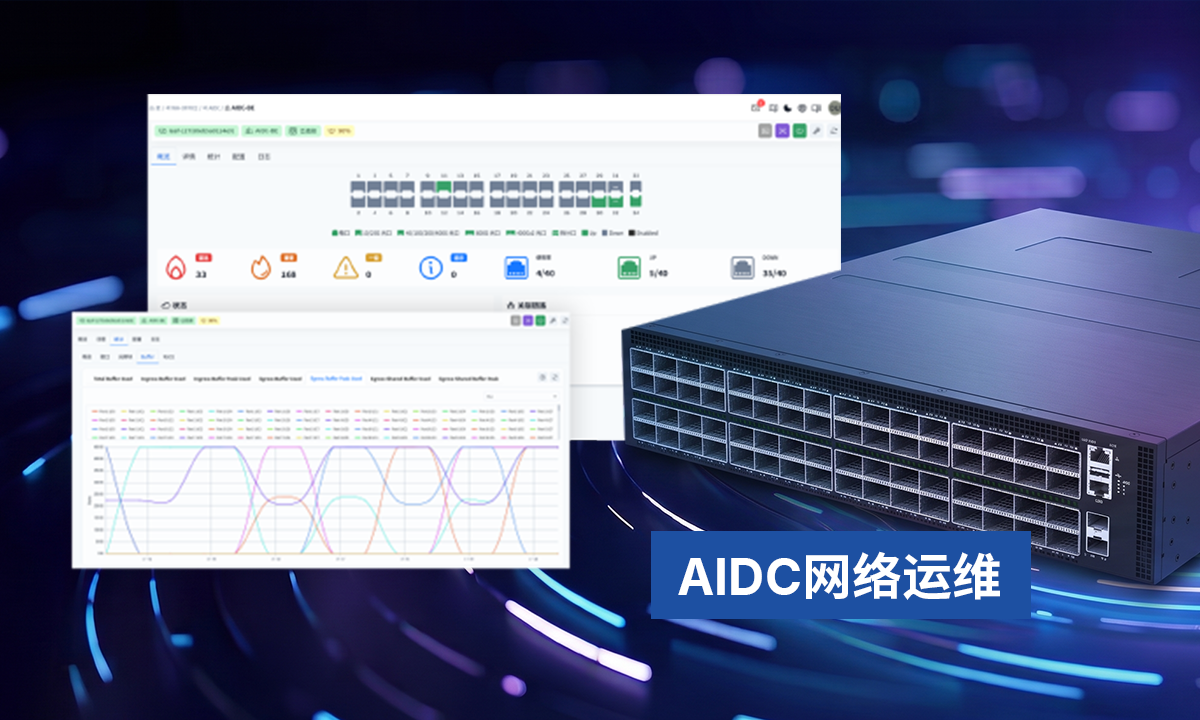
AIDC网络运维

人工智能技术的快速发展正在深刻改变数据中心的建设模式。随着大模型参数迈入万亿级,算力集群规模从千卡向万卡乃至十万卡持续演进,网络互联性能成为了制约AI训练与推理效率的一大关键因素。

相比传统互联网云业务,AI 工作负载呈现出显著不同的流量特征,例如高并发通信、长时间持续的大流,以及基于 RoCE/RDMA 的低时延和高吞吐。

这些特性对数据中心网络在带宽利用率、时延控制及无损传输能力方面提出了更高要求。在此背景下,传统数据中心以设备为中心的分散式管理模式逐渐暴露出局限性。

  • 配置效率低、易出错:逐台设备手工配置,耗时费力、周期漫长,更易因人为操作失误导致网络故障,严重制约业务上线速度
  • 配置复杂,依赖个人经验:无损以太网相关参数配置(如PFC、ECN等)繁多,缺乏标准化指引,传统方式高度依赖工程师个人经验完成部署和场景调优
  • 分散管理,故障难定位:传统网络设备采用分散管理方式,缺乏统一的状态监控手段,故障发现滞后、排查链路长,影响到业务连续性

星融元 AIDC 网络运维平台

星融元 AIDC 网络运维平台专为现代 AIDC 网络打造,以集中化视角统筹全局网络资源,适配 AI 训推等高算力场景网络需求。

AIDC控制器登录界面

该平台具备直观高效的 Web 管理界面,聚焦交换机设备的集中管理与网络能力优化,提供统一的配置下发、状态监控与拓扑可视化能力,并通过自动化与策略化控制提升部署效率与运行稳定性,确保大规模网络高并发场景下的高效运行。

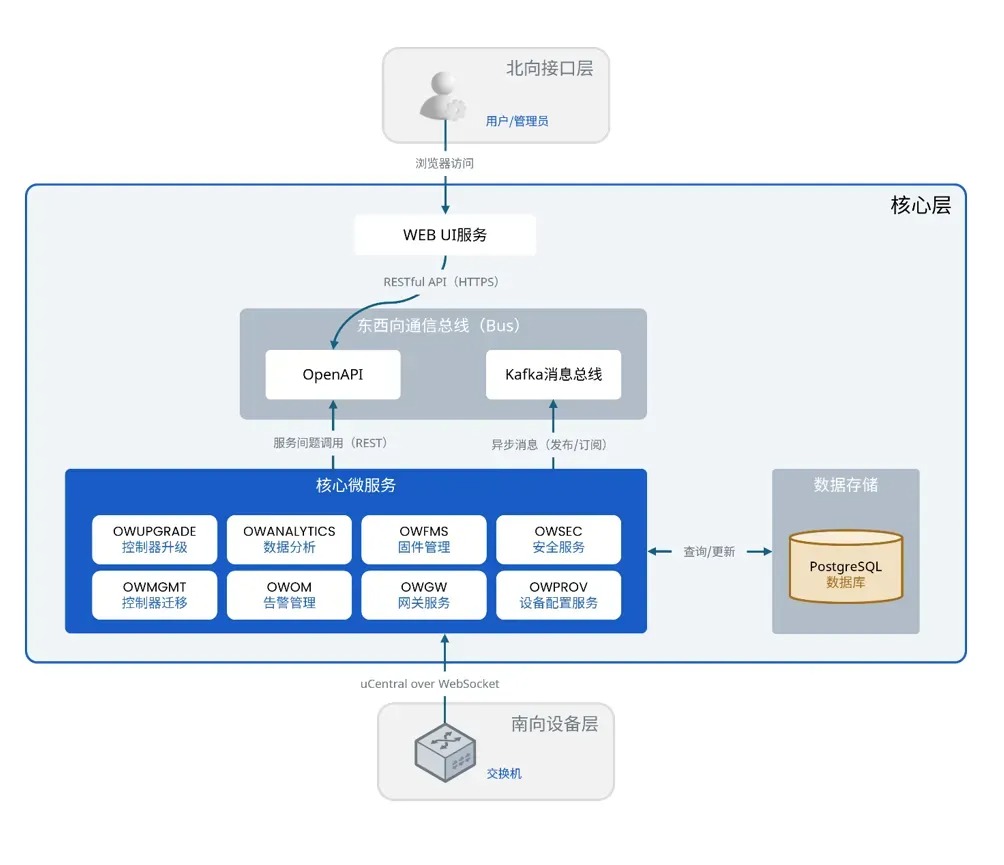
平台总体架构

运维平台架构

星融元 AIDC 网络运维平台基于 TIP OpenWiFi Cloud SDK 构建,采用微服务架构将系统功能划分为多个独立服务,以容器化方式部署运行,各服务通过标准接口交互,实现功能解耦与弹性扩展。

  • 北向接口层:通过直观的 Web UI 与标准化的 RESTful API,为用户提供统一、便捷的管理与操作入口,实现交互规范化。
  • 核心层:基于微服务架构,封装设备配置、固件管理、数据分析等核心能力,各服务独立运行,提升系统稳定性
  • 南向设备接入层:依托 owgw 网关服务,基于 uCentral over WebSocket 协议与交换机建立长连接,保障设备通信的实时性与可靠性。
  • 数据存储:采用 PostgreSQL 数据库实现配置数据与设备状态数据的集中、持久化存储,支持高效的查询与事务处理。

功能1: 业务快速部署和开局

星融元 AIDC 网络运维平台通过自动化部署与模板化编排能力,完成从设备接入、拓扑规划到配置下发的全流程简化,显著提升网络开局效率。

设备自动上线入库

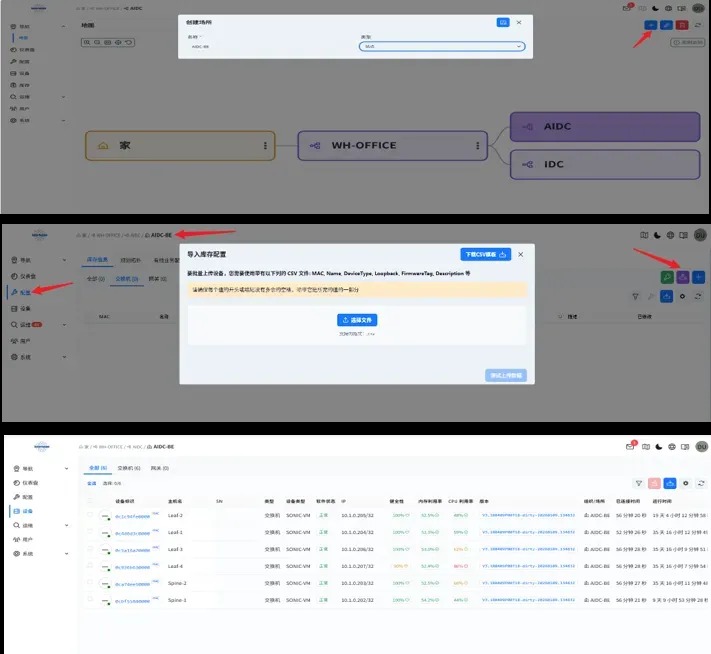
在管理界面中,创建专属的物理场所(如“AIDC-xx”),用户可通过 CSV 文件批量导入设备的MAC地址、型号与命名信息,在平台内建立设备资源库信息。

设备上架上电,并配置网络运维平台IP地址后,将自动通过 WebSocket 与平台建立连接,进入设备资源库等待分配。

设备自动上线入库

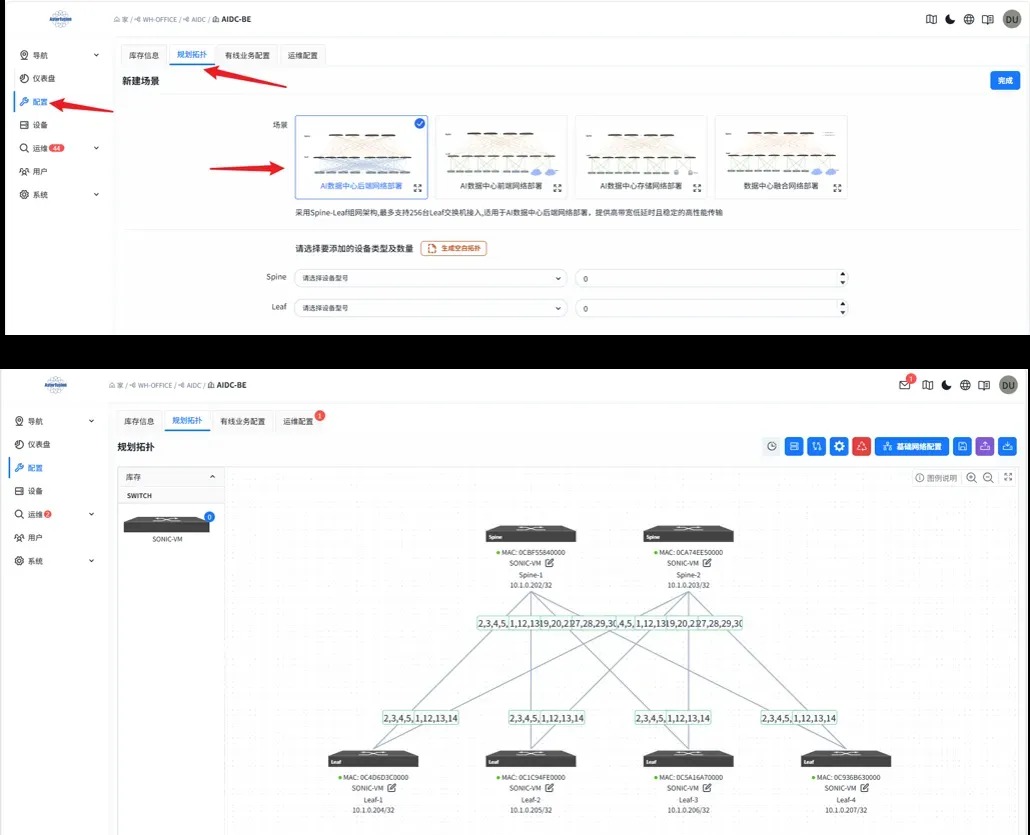
多场景网络拓扑模板

平台内置了多场景的标准场景模板,预集成对应的网络结构与关键特性,用户可基于模板快速完成网络规划与部署。此外,用户也可导入本地预先规划的拓扑文件,无需从零开始构建。

多场景网络拓扑模版

  • AIDC 后端网络(GPU训练网络) :采用 Spine-Leaf 架构,支持大规模节点接入,并集成RoCE、智能选路及ARS(自适应路由切换)等能力,以满足高带宽、低时延及无损传输需求。
  • AIDC 前端网络(业务管理网络):基于 EVPN MC-LAG 技术实现链路冗余与业务隔离,保障业务接入的高可靠性。
  • AIDC存储网络(存储后端网络):结合分布式网关、MC-LAG及RoCE技术,提升存储访问性能与可靠性。
  • DC融合网络:支持基于 EVPN MC-LAG或 EVPN Multihoming 的典型组网方式,适用于传统数据中心业务场景。

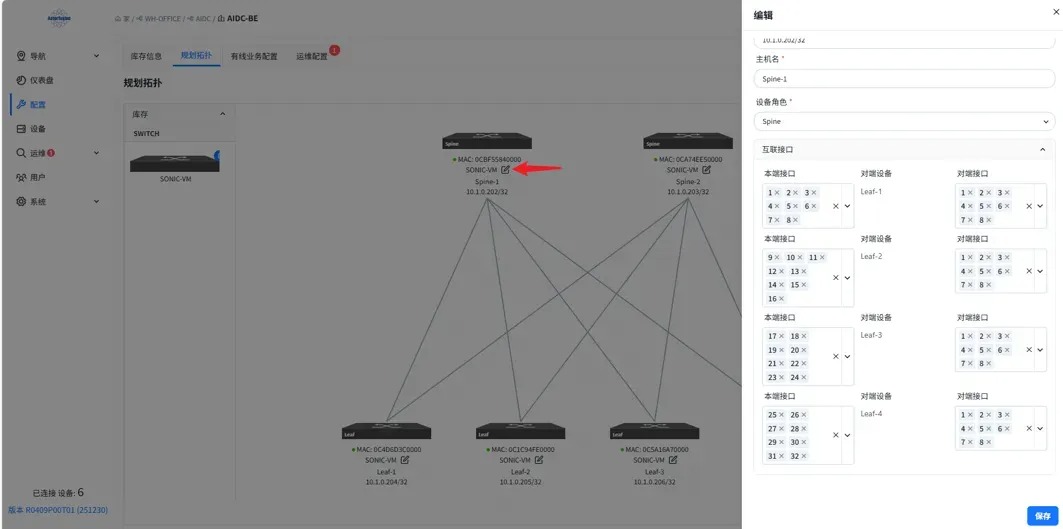
该界面同时支持用户手动编辑,为交换机设备分配具体角色,并配置设备间的互联链路参数。

互联链路参数

拓扑一致性自动校验

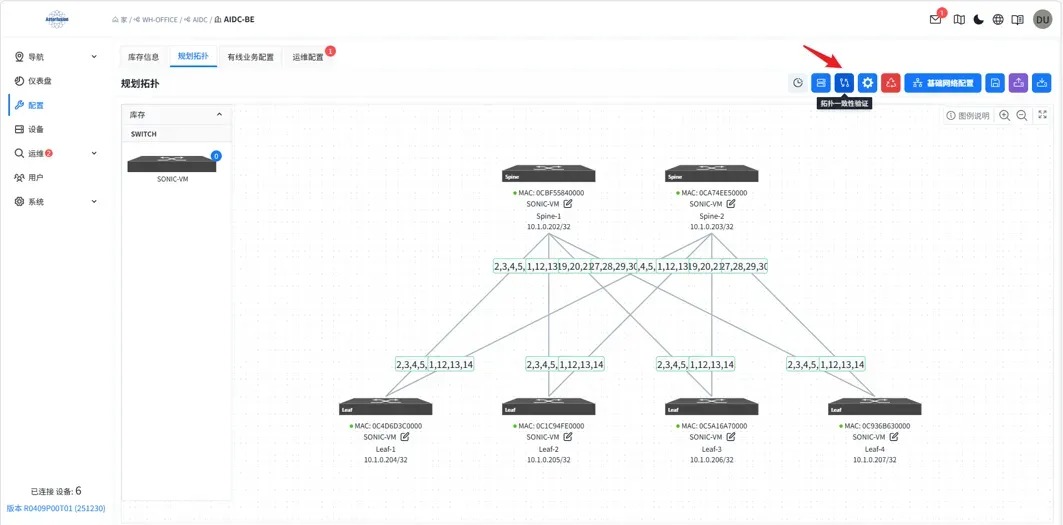
设备上线后,网络运维平台能够自动发现设备间的链路关系,生成真实网络拓扑。用户可一键执行“拓扑一致性验证”,扫描真实网络拓扑并与规划拓扑比对,精准识别物理连线错误,确保规划方案与实际部署完全一致。

拓扑校验

分步批量下发配置

该阶段采用“先基础网络、后业务配置”的分步下发策略,有序完成网络打通与业务加载。以AI智算训练网络为例主要有以下流程:

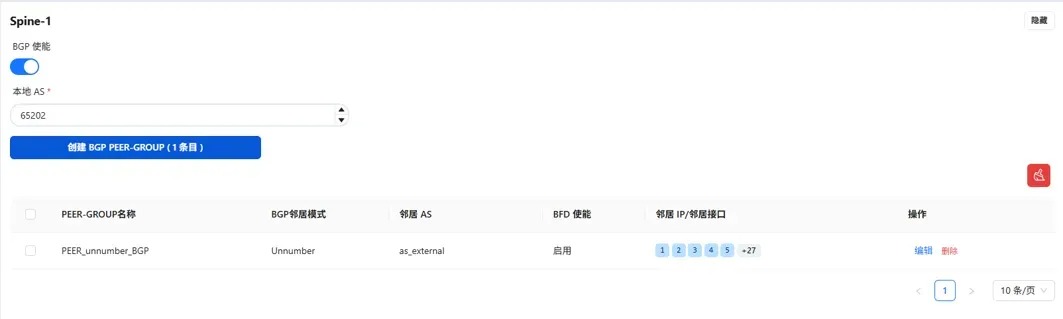
  • 建立基础连接:自动建立BGP邻居,用户无需为互联口手动规划IP地址;Spine交换机宣告各 Rail 网段路由,实现全网互通,BGP Peer-group 批量下发,向全网设备推送基础网络配置,等待状态同步完成即可进入业务配置阶段

建立基础连接

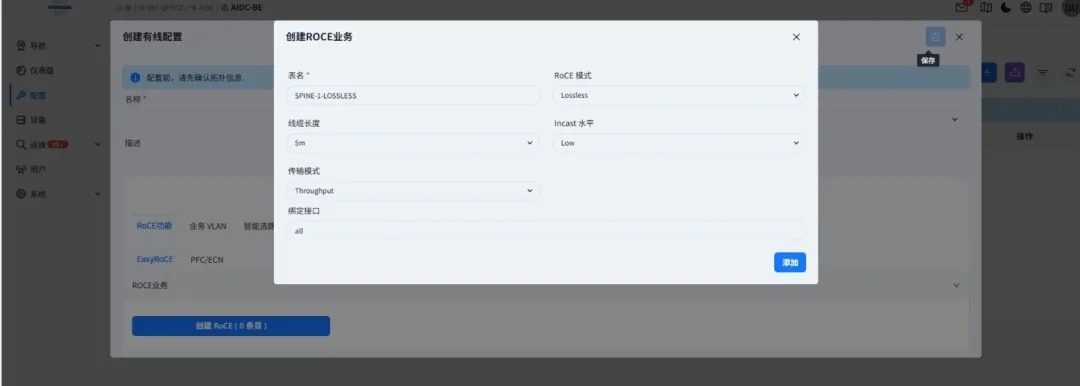
  • 启用RoCE功能:选择适配业务场景的RoCE模板,匹配无损网络必备的 PFC/ECN 策略,为低时延通信提供支撑

启动RoCE

功能2:RoCE 参数模板化配置和灵活调优

在AI数据中心网络中,RoCE相关参数 (如PFC、ECN) 的配置对网络性能具有重要影响。然而,不同业务场景下对时延、吞吐及拥塞控制的要求存在差异,若完全依赖人工逐项配置,不仅复杂度高,也难以保证参数组合的合理性。

星融元 AIDC 网络运维平台采用“模板化配置+参数微调”的方式,来帮助用户实现面向多场景的 RoCE 网络高效部署与精细优化。

基于场景的RoCE配置模板

平台内置多种面向典型 AI 业务场景的 RoCE 参数模板,预定义 PFC 优先级、ECN 标记策略等关键参数组合。用户可根据业务类型选择合适模板,快速完成网络基础配置,降低参数配置复杂度。

RoCE 参数动态调优

在模板基础上,平台支持对 PFC、ECN 等关键网络参数进行实时微调,无需中断业务即可适配流量负载的动态变化,保障数据传输的低延迟与高稳定性。

RoCE参数调优

RoCE参数调优

功能3:设备集中管控和运维

AIDC网络运维平台面向大规模数据中心网络,通过集中化管控与可观测体系,提升网络运维效率并降低人工操作复杂度。

一站式纳管

交换机设备上线后自动纳入平台统一管理,并进入默认资源池(组织)。

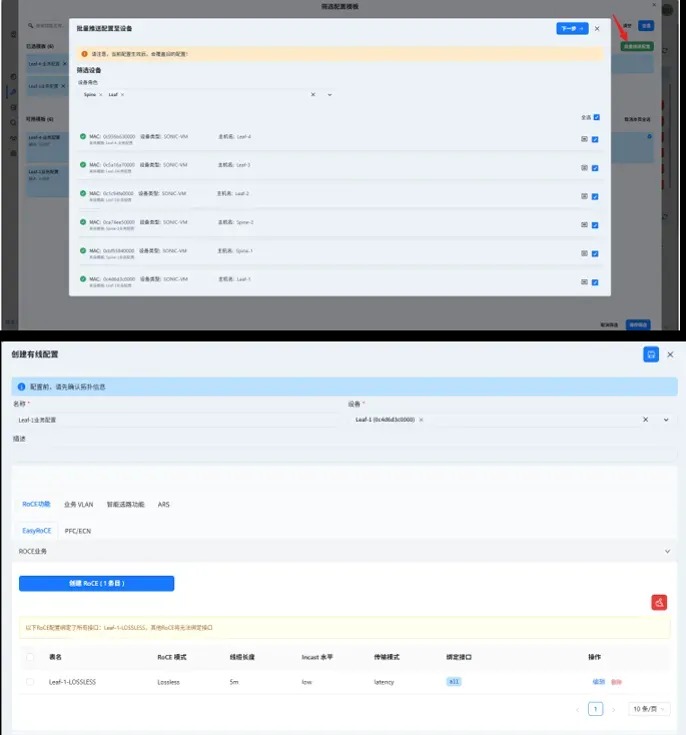
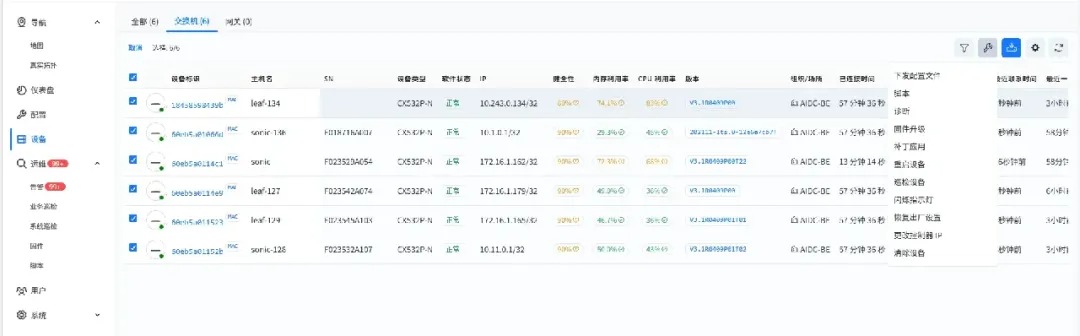
管理员可根据实际部署需求,将设备批量划分到指定场所或业务域,并在一处位置集中完成对指定设备的配置下发与修改、配置文件统一管理(查看、导入、导出)、远程命令执行与自动化脚本下发和其他运维操作(重启、升级等)。

一站式纳管

网络可观测性

设备运行状态和接口流量

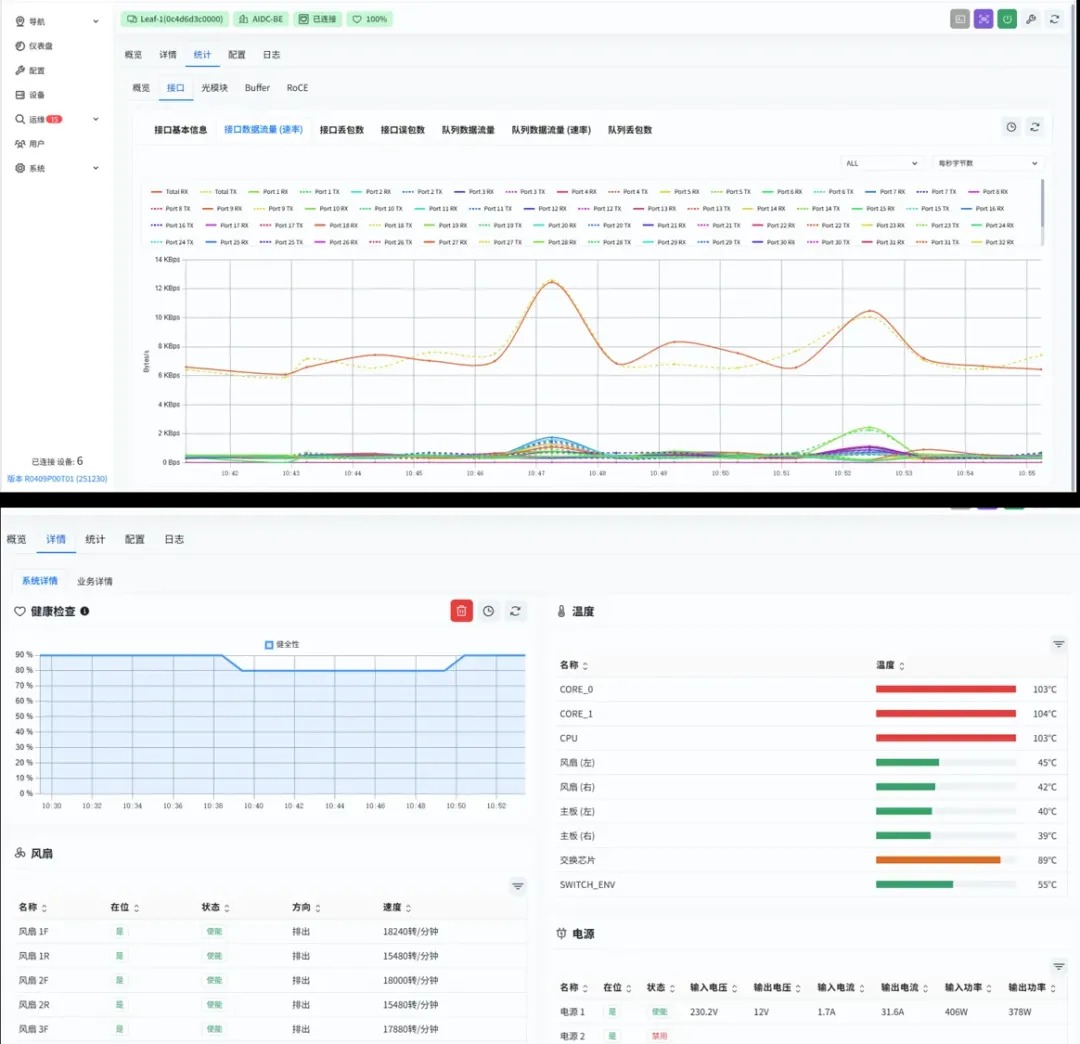
呈现交换机设备层的健康度,例如交换机CPU利用率、内存使用率及接口运行状态等硬件基础信息,以及实时/历史的交换机接口和队列收发速率、带宽利用率,并精准统计各类丢包误包数据,为网络带宽规划、异常流量排查提供数据支撑。

设备运行状态和接口流量

业务运行状态

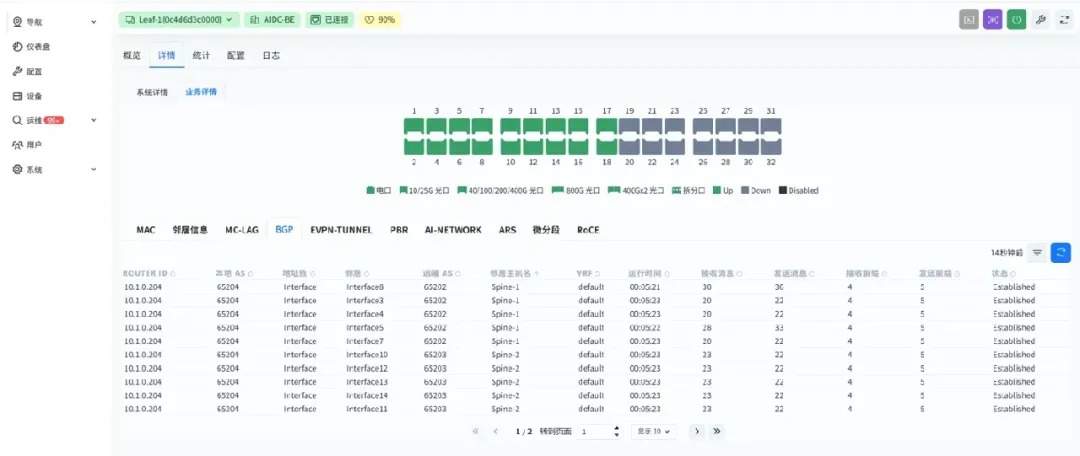
提供网络中 VLAN、RoCE、ARS 等核心业务的详细状态概览,整合关联接口、配置参数与实时运行状态,帮助管理员洞察业务层的健康度。

业务运行状态

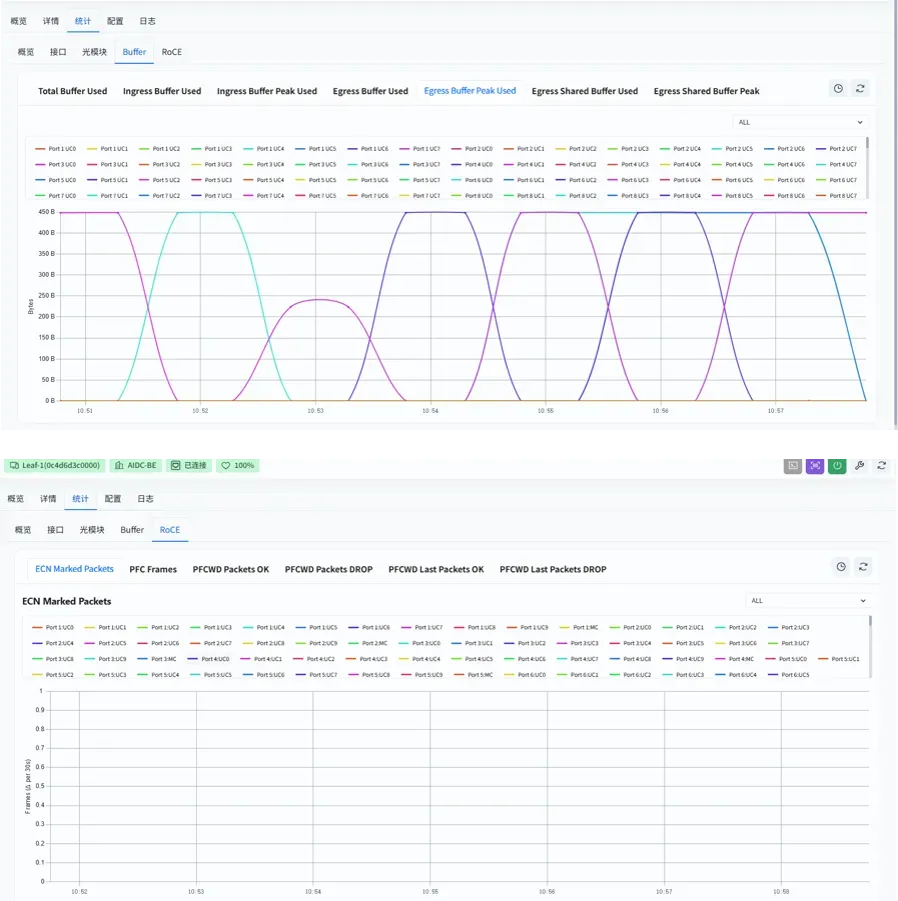
无损网络信息统计

交换机上 PFC帧、ECN 标记与丢包及RDMA流量统计,实时监控各队列 Buffer 资源使用情况,预警拥塞。

无损网络信息统计

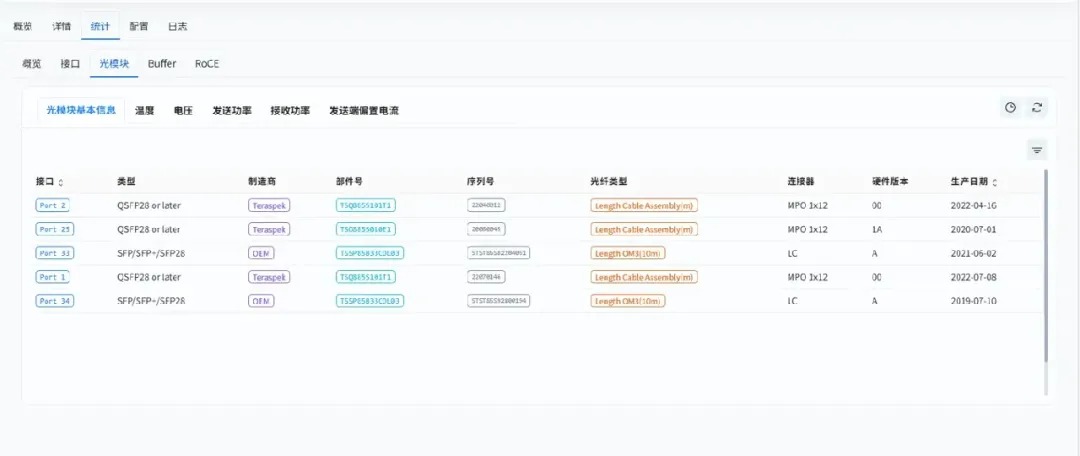
光模块工作状态

实时采集光模块温度、电压、收发功率及告警状态等关键指标。对功率衰减、温度异常进行提前预警。

光模块工作状态

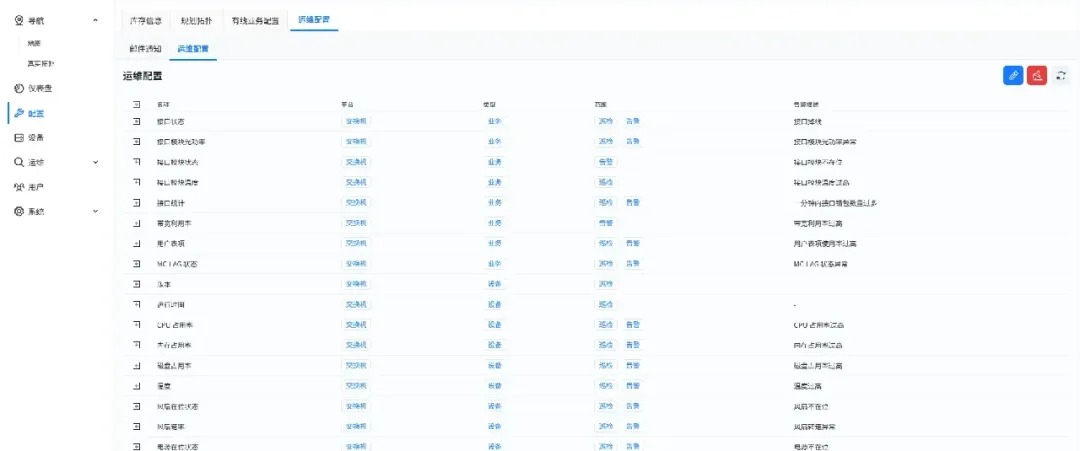
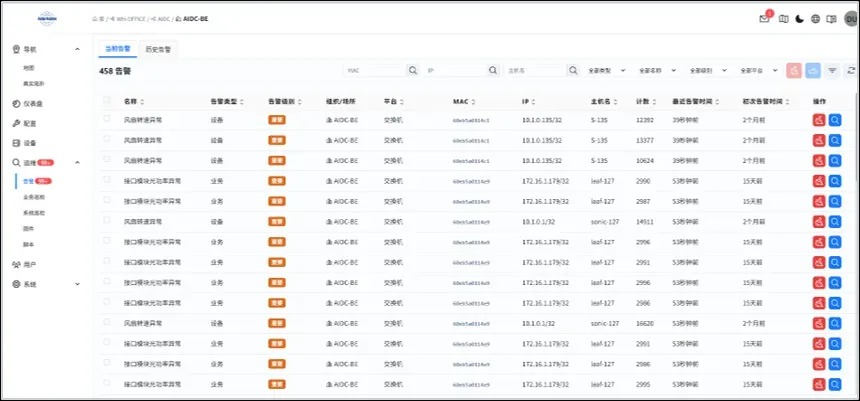
实时告警和智能巡检

网络运维平台提供基于监控数据的告警与巡检机制,提升网络运行的稳定性与可维护性。告警机制支持自定义告警阈值与通知策略,实现对设备状态、资源利用率及硬件运行状态的实时监控与告警。

实时告警和智能巡检

实时告警和智能巡检

平台支持一键巡检及周期性巡检,对设备关键指标 (如CPU、内存、进程状态及日志) 进行自动检查,并生成巡检报告。

多组织和权限管理

网络运维平台支持多组织架构,可按照地域、部门或业务进行分级管理,不同管理员可在各自权限范围内进行操作。

多组织和权限管理

系统迁移和配置复用

平台支持对系统配置进行整体导出与导入,例如在系统扩容、迁移部署及灾备恢复时,管理员可一键导出当前平台配置,并在目标平台中进行导入,减少重复配置工作。

系统迁移和配置复用

交换机产品系列

当前 AIDC 网络运维平台已全面支持星融元 AIDC 交换机产品 —— CX-N 系列。

星融元(Asterfusion)CX-N系列数据中心交换机面向智算中心和云计算数据中心提供一站式全开放网络解决方案,具备低时延、高性能、高密度等特性。其依托业界领先的超低时延交换芯片,采用先进的硬件架构设计,提供高密度25GE~800GE端口,充分满足用户多样化的端口接入需求。

运行在CX-N交换机之上的 AsterNOS,是星融元为智算中心和云计算数据中心设计开发的开放网络操作系统。

本产品全系列标配RoCE特性,并基于用户生产网络进行优化,提供了EasyRoCE、智能负载均衡、PFC/ECN等无损网络特性,并集成了VXLAN、EVPN等丰富的数据中心特性。


产品型号: 星融元(Asterfusion)CX864E-N (64 x 800G OSFP)
功能特性:RoCEv2, PFC, ECN, DCBX ……
应用场景:GPU算力集群,分布式存储
最后更新:2026-05-18


相关文章

星融元数据技术有限公司是领先的开放网络解决方案提供商,产品包括网络操作系统、数据中心交换机、AI智算交换机、园区交换机、开放式企业级路由和新一代网络可视化产品等。为行业企业、数据中心和云运营商提供基于通用解耦硬件和 SONiC 软件框架的全场景交钥匙网络解决方案,帮助用户构建AI时代中立、透明,易于运维、高性价比的基础网络。

🔺关注 @星融元Asterfusion 微信公众号
WeChat QR Code

对星融元产品感兴趣?

立即联系!

返回顶部

© 星融元数据技术(苏州)有限公司 苏ICP备17070048号-2